读懂 ReAct:从推理与行动,到一个真正运行的 Agent
从一行 stop 参数出发,理解模型、工具与运行程序的边界。
4HET · 学习笔记 · 2026 年 9 月
我学习 ReAct 时,最先卡住的地方不是代码,而是一张流程图:任务交给模型,模型生成动作,环境返回结果,然后模型继续生成动作。
这不就是普通 Agent 的交互循环吗?如果它已经会根据反馈行动,ReAct 到底增加了什么?
后来,我又遇到了两个问题:为什么论文里 ReAct 的 HotpotQA 成绩低于 CoT?为什么一段很短的 Python 代码,要特意阻止模型生成 Observation:?
这篇文章沿着这些问题展开。前半部分理解方法,后半部分拆解实现,再回过头判断它适合什么任务。代码中的轨迹使用教学模拟数据;论文数字来自原文,不是我的复现实验。
1. 有交互循环,就算 ReAct 吗?
先把三件事分开:模型可以推理,可以选择动作,也可以通过工具获得外部信息。它们并不天然等价。
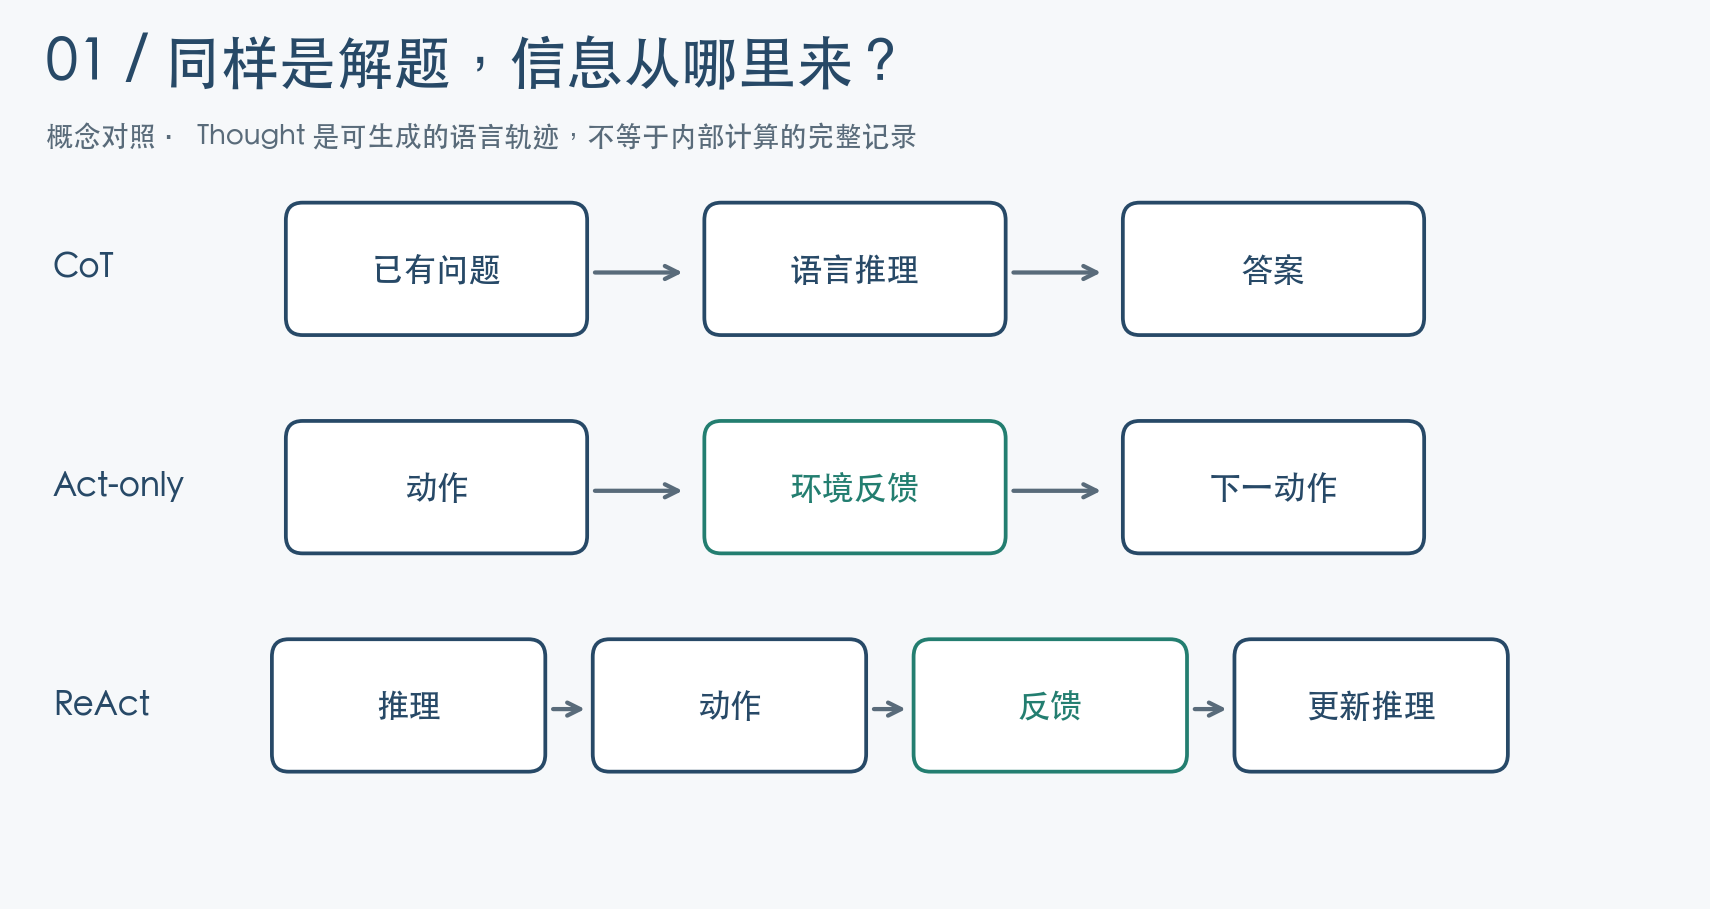
图 1:概念示意。蓝色表示模型侧处理,绿色表示环境信息;Act-only 没有显式语言推理轨迹,不意味着模型内部没有计算。
在原论文的比较中,CoT 保留推理,Act-only 保留行动与观察,ReAct 则将语言推理轨迹和任务动作交错起来。推理可以整理信息、跟踪进度、修改计划;行动让模型接触到当前上下文之外的信息。[1]
我最初把区别理解成“有没有打印 Thought”。这个判断太表面。原论文确实使用显式语言轨迹,但在较长的决策任务里,Thought 可以只出现在关键位置,不要求每个动作前都写一段。
同时,不能看到今天一个系统连续调用工具,就断言它严格复现了原论文。更稳妥的说法是:它采用了类似 ReAct 的动态交互方式;是否使用显式推理、如何组织轨迹,还要看具体实现。
我现在理解的核心是:推理指导行动,行动带回的信息又改变后续推理。 这个过程不是简单地把一份预先生成的行动清单执行到底。
2. 用一次失败的查询,看懂控制权交接
设想一个教学任务:核实虚构论文《ExampleAgent》的会议年份。我们准备一个本地资料库,让第一次宽泛查询返回同名提示,第二次精确查询返回会议记录。
下面的“决策说明”是为了讲解而写的简短示例,不是某个模型真实内部思维的记录。
| 轮次 | 模型侧的决策说明与动作 | 运行程序取得的结果 |
|---|---|---|
| 1 | 先查询论文名称;search[ExampleAgent] | 同名记录不止一条,请补充完整标题 |
| 2 | 当前结果不足以确定年份;search[ExampleAgent: A Toy Study] | 本地模拟会议记录:ExampleConf 2024 |
| 3 | 信息已足够;finish[2024] | 程序结束,不再执行搜索 |
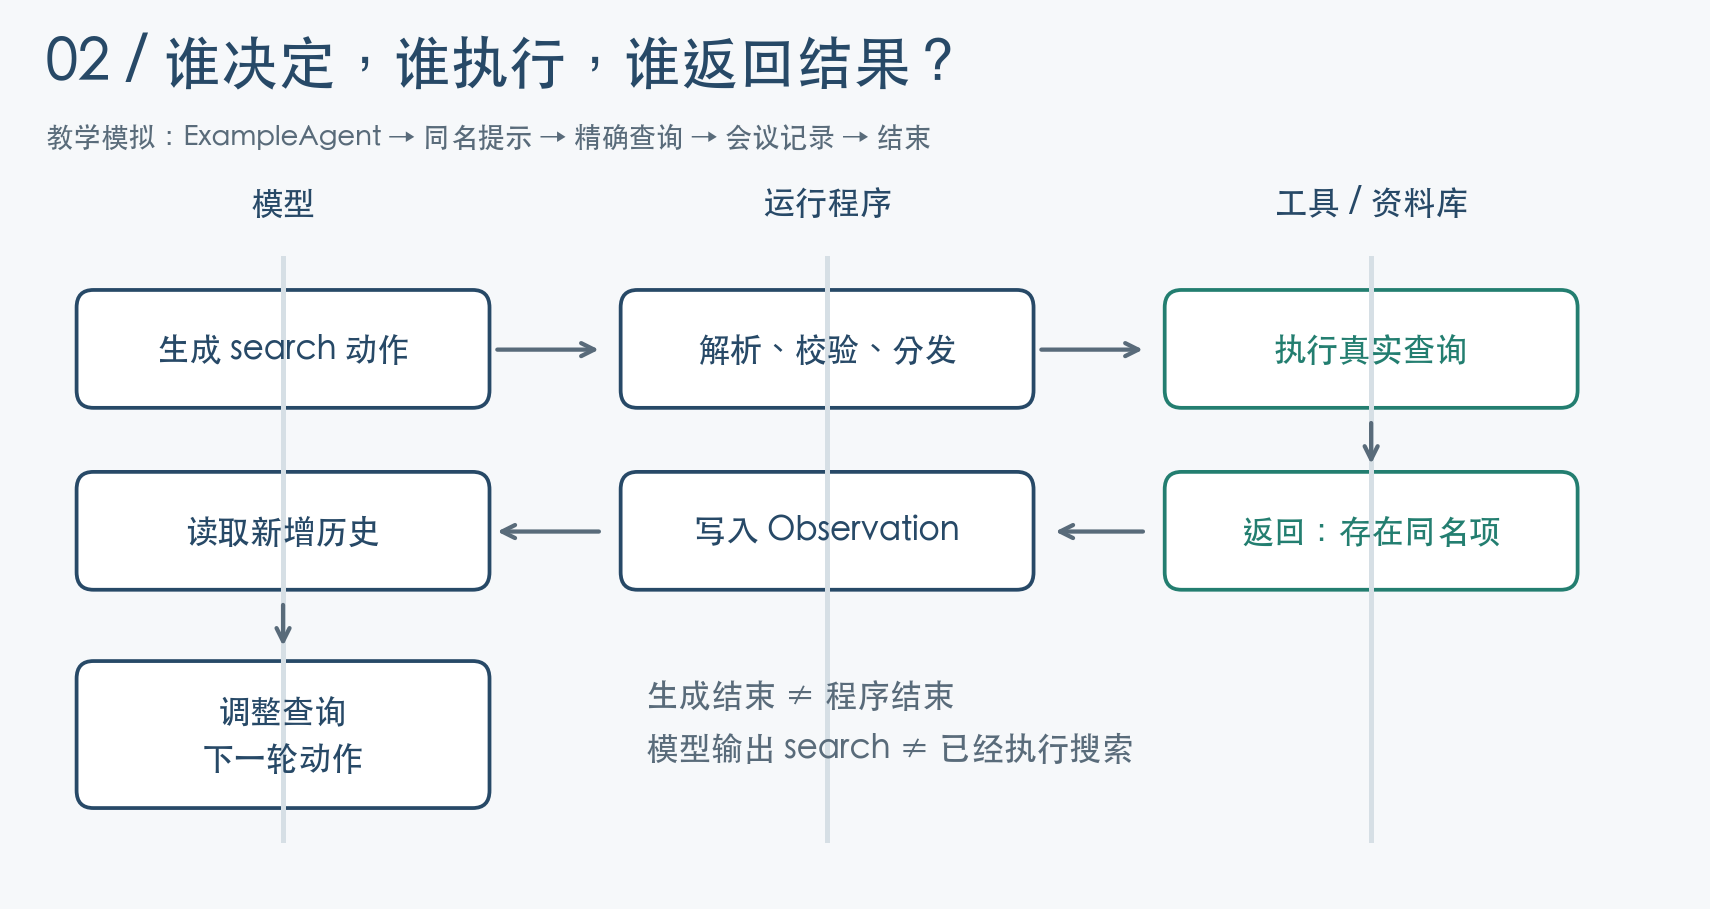
图 2:三条泳道分别表示模型、运行程序和工具。模型输出动作后,控制权必须回到程序,才会发生真实调用。
这个例子里最重要的动作,其实是第二次查询。它不是第一轮提前确定的,而是由新反馈触发的。
但模型写出 search[...] 并不会自动连接搜索引擎。运行程序还要解析名称和参数,找到对应函数,执行它,再将返回值加入上下文。文本中出现工具调用,和工具确实执行,是两件事。
这也是排查 Agent 时应该保存调用日志的原因。只看一段流畅的回答,无法确认其中的“搜索结果”是否真的来自搜索。
3. ReAct 与 Reflexion:一个执行循环,可以被放进更大的循环
我最初的讨论从 Reflexion 开始,因此也需要交代它和 ReAct 的关系。
ReAct 关注任务进行中怎样交错推理与行动;Reflexion 则利用反馈形成文字反思,并将经验保留给后续尝试。它们可以组合:执行任务的 Actor 采用 ReAct 式循环,外层再加入评估、反思和记忆。[2]
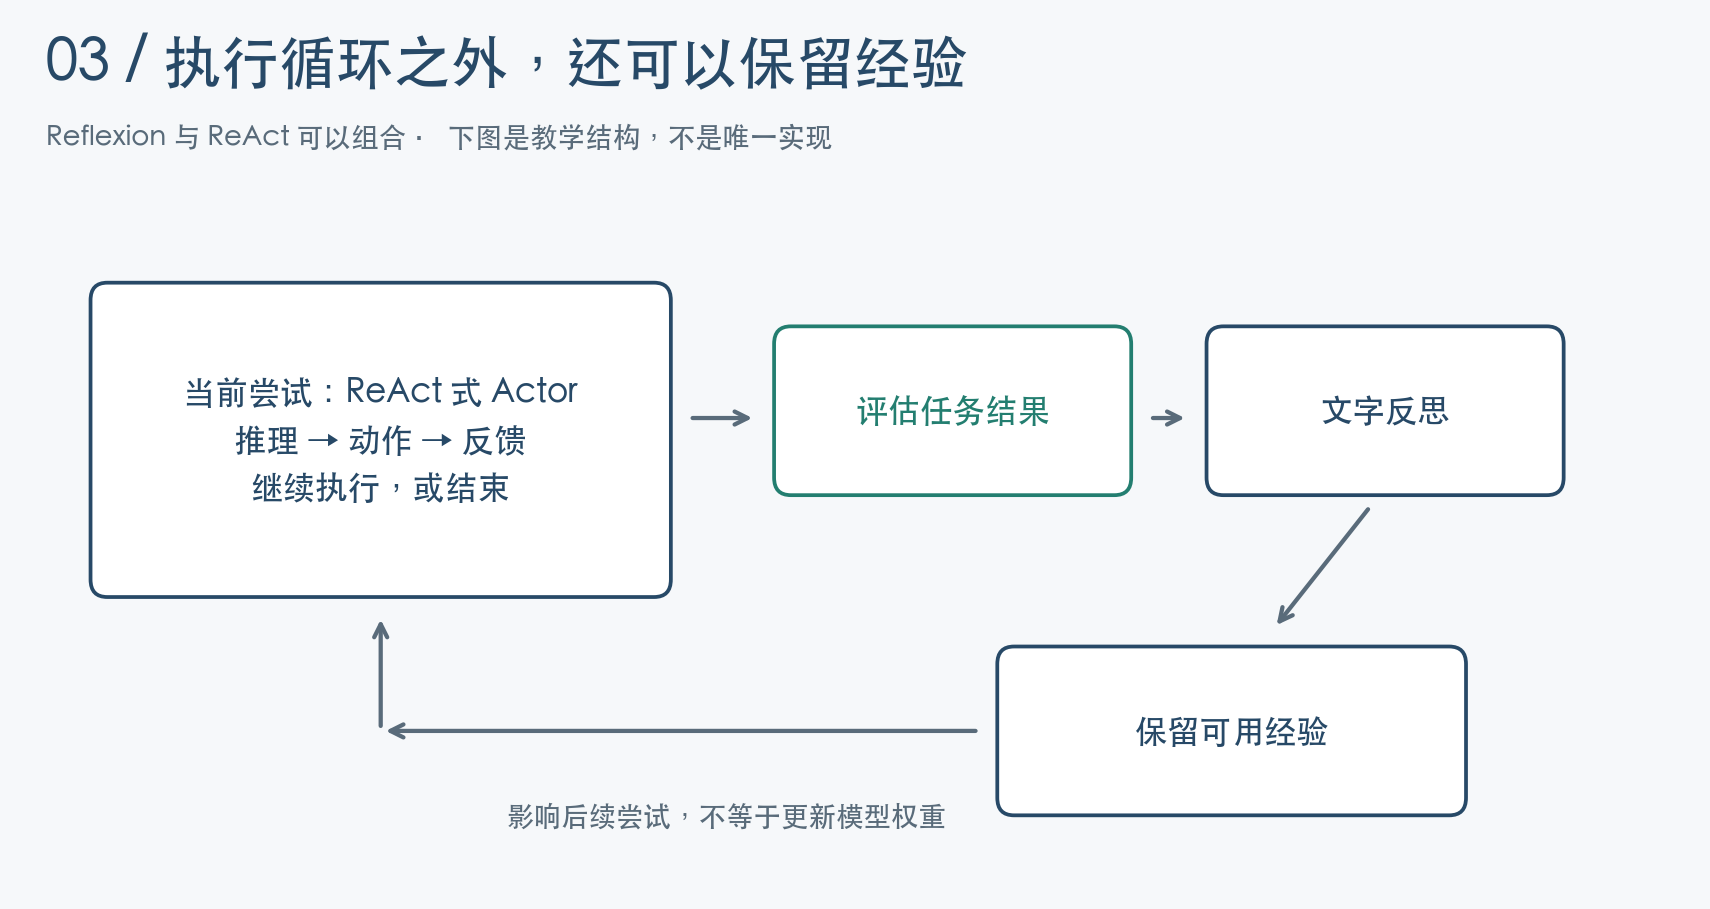
图 3:组合关系的教学示意,不表示所有 Reflexion 实现都必须采用相同的组件连接方式。
| 对比项 | ReAct | Reflexion |
|---|---|---|
| 主要关注 | 当前尝试的下一步行动 | 怎样利用反馈改善后续尝试 |
| 典型信息 | 当前轨迹和工具结果 | 评估反馈、文字反思和保留的经验 |
| 需要避免的误解 | 有工具就自动等于 ReAct | 多生成一句“我反思一下”就完成了学习 |
二者都不能保证成功。错误反思也可能被保留下来;当前历史和跨尝试记忆都需要明确管理。
4. 为什么能搜索,HotpotQA 成绩反而更低?
原论文的 PaLM-540B 提示实验给出了下面的结果。[1]
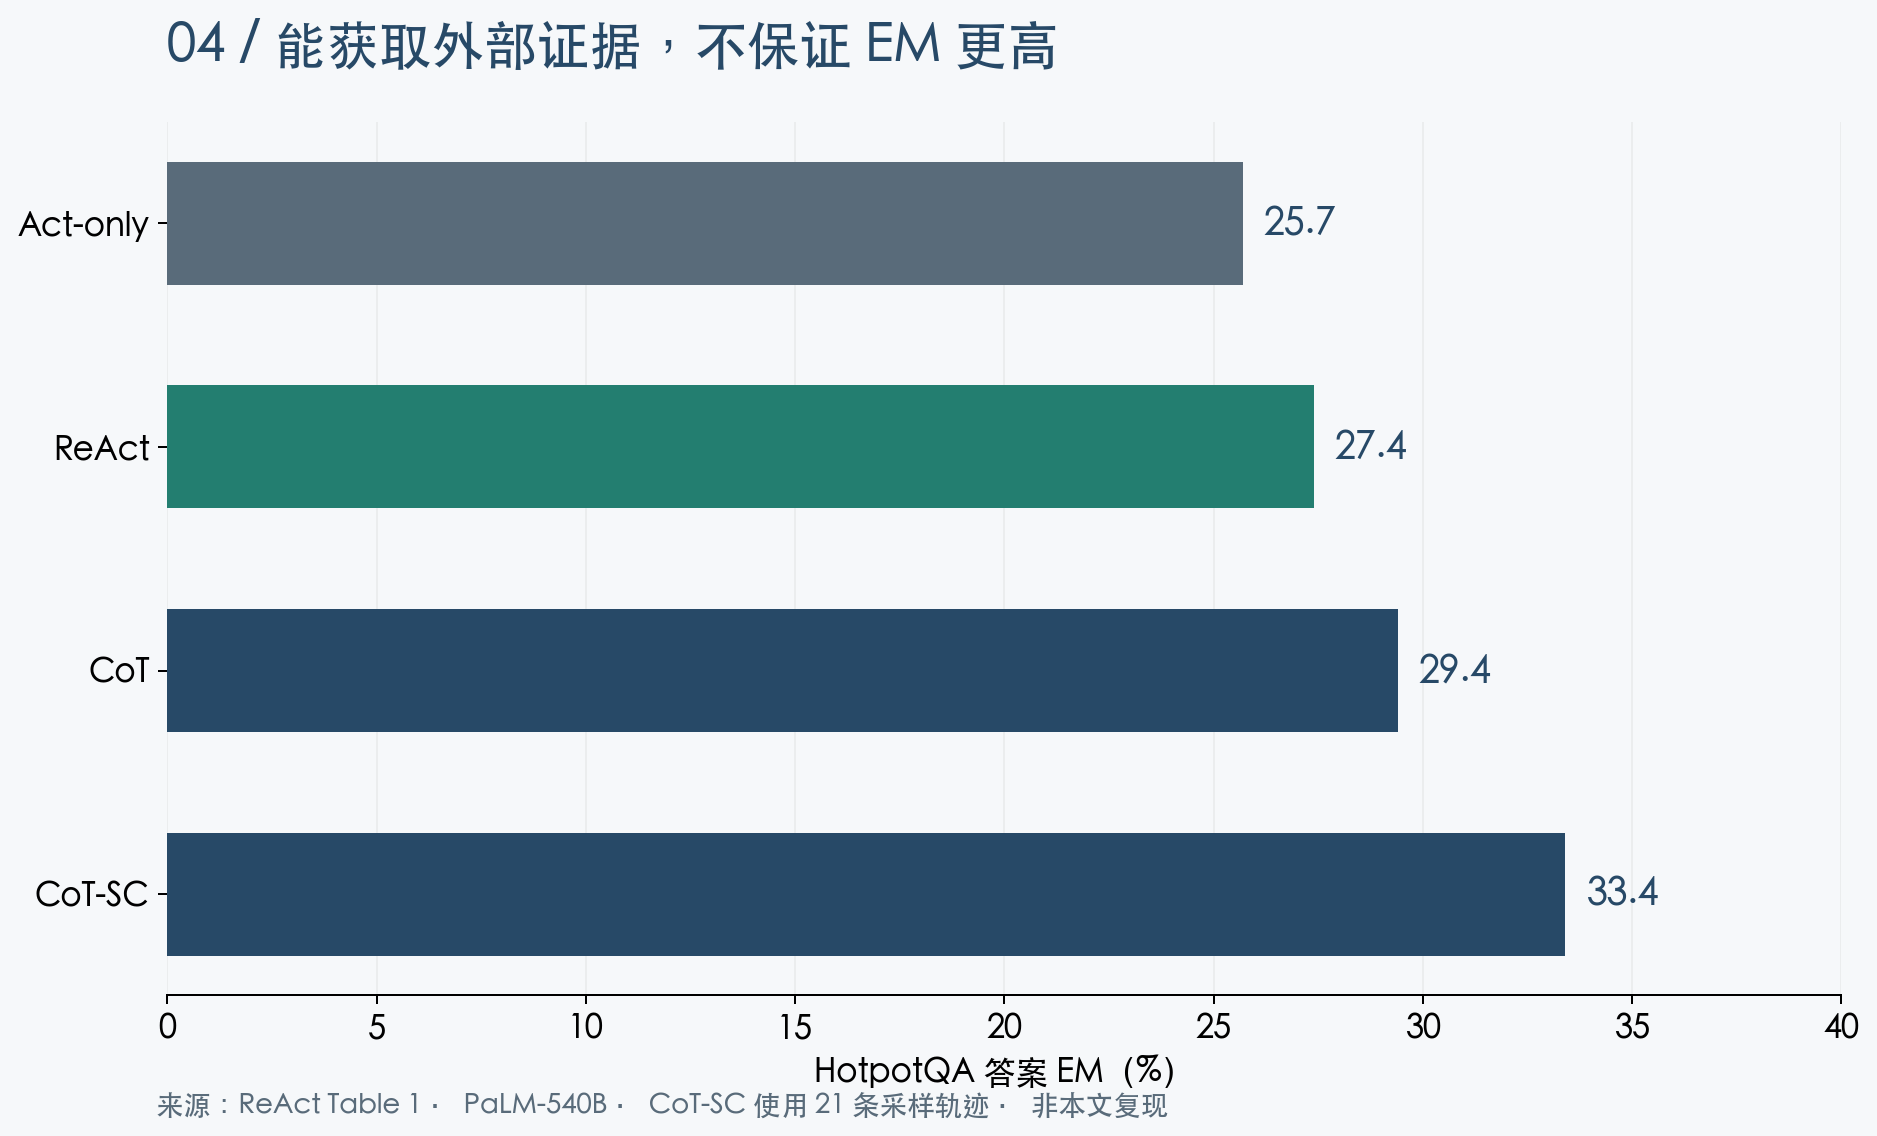
图 4:HotpotQA 答案 EM,单位为百分比。CoT-SC 使用 21 条采样轨迹,不能视为与单轨迹方法等预算。这里只转录原论文 Table 1,不代表当前模型的表现。
我一开始容易把“能查资料”理解成“应该答得更准”。但增加信息来源,也增加了查询、执行和理解结果的失败机会。
论文的人工错误分析观察到了无信息搜索、重复动作和推理错误等问题。因此,外部证据更充分与最终答案更准确,并不是同一个指标。作者也研究了 ReAct 与 CoT-SC 的回退组合,而不是要求每个问题都始终使用一种方式。[1]
这里有三个值得修正的直觉。
第一,EM 不是原始字符串一字不差地比较。 HotpotQA 的官方脚本会进行大小写、标点、英文冠词和空白归一化,但归一化后仍要求答案匹配;它不是开放式的语义评分。[3]
第二,可能的解释不等于实验已经证明的原因。 “模型本来就知道”“搜索过多把答案带偏”可以帮助理解失败机制,但不能凭想象认定它们解释了这组数字。
第三,多步交互不是简单的独立概率连乘。 有些步骤失败后可以恢复,有些路径可以替代,有些错误彼此相关。用每步成功率直接相乘,只能解释非常受限的假设场景。
我会把这个结果记成一个工程提醒:工具扩展能力,也引入新的失败位置。评价时应同时记录任务成功率、工具次数、耗时、成本和失败原因。
5. 教学版 ReAct 循环:约 50 行的实现骨架
这是我学习时读到的代码。保留它是因为结构足够直接,但它不是复制后就能完成真实任务的程序:llm 未提供,三个工具函数也是占位符。下面修正了工具表注释,其余核心控制逻辑保留。
import re
from typing import Callable, Dict

# 占位接口:真实使用时必须实现
# python 工具需要真正的隔离与资源限制,注释不等于实现

def search_engine(q: str) -> str: ...
def kb_lookup(key: str) -> str: ...
def run_python(code: str) -> str: ...

# 工具名称 -> 执行函数;这里尚无参数 schema 或工具说明
TOOLS: Dict[str, Callable[[str], str]] = {
    "search": lambda q: search_engine(q),
    "lookup": lambda key: kb_lookup(key),
    "python": lambda code: run_python(code),
    "finish": lambda ans: ans,
}

REACT_PROMPT = """You are a ReAct agent. At each step, output:
Thought: <brief decision rationale>
Action: <tool>[<arg>]

Tools: search, lookup, python, finish.
End with Action: finish[<answer>].
Question: {question}
"""

ACTION_RE = re.compile(r"Action:\s*(\w+)\[(.+?)\]", re.DOTALL)

def react_loop(llm, question, max_steps=8):
    history = REACT_PROMPT.format(question=question)
    for step in range(max_steps):
        out = llm(history, stop=["Observation:", "Question:"])
        history += out

        m = ACTION_RE.search(out)
        if not m:
            return None, history, "parse_fail"
        name = m.group(1).strip().lower()
        arg = m.group(2).strip()

        if name == "finish":
            return arg, history, "ok"
        if name not in TOOLS:
            obs = f"[Error] Unknown tool {name}."
        else:
            try:
                obs = str(TOOLS[name](arg))[:512]
            except Exception as e:
                obs = f"[Error] {type(e).__name__}: {e}"[:256]

        history += f"\nObservation: {obs}\n"

    return None, history, "max_steps"
5.1 历史是输入,不是自动存在的记忆
history 最开始只有协议和问题。随后,程序把模型输出与工具返回不断追加进去。下一轮调用时,模型才能看到前面的过程。
因此这里的历史可以作为当前尝试的上下文状态,但不自动构成持久记忆。进程结束后保存在哪里、下一次是否读取、长历史怎样筛选,这段代码都没有处理。
5.2 stop 停止生成,不是停止整个程序
我反复追问的是这一行:
out = llm(history, stop=["Observation:", "Question:"])history 决定输入;stop 请求模型接口在遇到指定字符串时结束本次生成。它是否受支持、匹配字符串是否保留,要看具体接口契约。
本次模型调用结束后,Python 仍然继续执行解析、工具调用和下一轮循环。这里交接的是控制权。
在文本续写的实现里,我们希望模型返回动作后就交还控制权,避免把自己生成的 Observation 当成工具结果。但是,“没有 stop 就几乎一定崩”太绝对。结构化工具调用也可以明确这个边界;而仅有 stop,也不能保证输出合法、答案正确或外部内容可信。
5.3 解析之后,动作才变成函数调用
如果模型返回 Action: search[ExampleAgent],正则提取出 name="search" 与 arg="ExampleAgent"。随后 TOOLS[name](arg) 才真正执行函数。
这份正则有明显限制。例如:
Action: python[items[0]]非贪婪匹配会在第一个右方括号停止,提取的参数不是完整的 items[0]。它也不接受空参数,并且只取第一个匹配动作。给代码工具传参时,这些都不是小问题。
5.4 回填 Observation,循环才闭合
history += f"\nObservation: {obs}\n"这句把工具返回加入下一轮输入。没有它,程序即使执行了搜索,模型也不会自动知道结果。
Observation 可以是资料,也可以是可恢复的错误。但来自工具不意味着内容必然正确,更不意味着其中的文字拥有修改任务和权限的资格。
5.5 finish 代表结束声明,不代表通过验收
finish 在分支里直接返回,所以工具表中的 finish 函数实际上不会执行。它在这里是终止动作。
返回状态 "ok" 容易造成误解:它只表示模型按照协议结束了。答案正确吗?任务要求的文件存在吗?修改后的测试通过了吗?这些需要另外验证。
6. 从文本 Action 到结构化工具调用
看懂前面的循环后,我又有一个疑问:既然已经能用 Action: search[...] 调用工具,为什么还要引入 Function Calling、Tool Calling,甚至 MCP?它们到底改了哪一段代码?
6.1 Function Calling 和 Tool Calling,改变的是哪一层?
Function Calling 通常指模型按照工具定义,生成函数名称和参数的接口能力;Tool Calling 常被用作近义词,也可以泛指更多工具类型。具体名称应以提供方的接口契约为准,不能仅凭名字划出一条统一的技术边界。
本节讨论由我们自己的程序执行的函数工具。模型生成调用请求,程序负责执行;一些平台也提供在服务端执行的搜索等工具,那是另一种执行归属,不能套用“所有工具都由我的 Python 执行”的说法。参见 Anthropic 的服务端工具说明。
ReAct 关心的是如何交替组织推理、行动与反馈;工具调用接口关心的是如何表达一次行动。一次 Function Call 不自动构成 ReAct,也不是给原来的循环换了一个更高级的名字。

图 5:动作的表达与解析方式可以改变,执行、回填和再次决策的责任仍然存在。接口返回的调用请求不等于工具已经运行。
| 原来的文本循环 | 使用结构化工具接口之后 |
|---|---|
| 在提示词中介绍工具 | 向接口提供工具名称、说明与参数 schema |
生成 Action: search[关键词] | 返回带名称、参数和调用 ID 的调用项 |
| 正则提取工具名与字符串参数 | 适配器读取调用项,必要时解析参数 JSON |
| 用工具表找到函数 | 仍然需要工具注册表、参数校验与执行策略 |
拼接 Observation: ... | 按接口协议回传与调用 ID 对应的结果 |
| 继续调用模型 | 保留必要历史,继续下一轮决策 |
例如,模型可以提出这样的调用。它是示意数据,不是某家 SDK 的完整响应格式:
{
  "id": "call_17",
  "name": "search",
  "arguments": {"query": "ReAct paper"}
}
有的接口把 arguments 返回为 JSON 字符串,有的 SDK 帮忙解析为对象。response.tool_calls 看起来只有一行,是因为一部分协议处理被封装起来了;模型仍然需要生成内容,也仍然可能提出错误的行动。
6.2 把原来的循环改成什么样?
下面是接口无关的伪代码。adapter、validate_and_authorize 等是待实现的边界,不是可以直接导入的库。它假定适配器能保留提供方要求的完整响应项,并把调用与结果转换成正确的消息协议。
def tool_loop(adapter, tools, question, max_rounds=8):
    history = adapter.start(question)
    for _ in range(max_rounds):
        response = adapter.generate(history, tools.schemas())
        # 保留调用项及提供方要求继续传回的其他响应项
        history = adapter.append_response(history, response)
        if adapter.refused_or_incomplete(response):
            return {"status": "needs_attention"}

        calls = adapter.calls(response)
        if not calls:
            answer = adapter.final_text(response)
            # 结束声明与任务通过验收是不同状态
            return {"status": "finished_unverified", "answer": answer}

        # 教学版串行执行;有调用时,不把同轮文本当最终答案
        for call in calls:
            try:
                args = adapter.decode_arguments(call)
                validate_and_authorize(call.name, args)
                result = tools.execute(call.name, args)
            except RecoverableToolError as error:
                result = safe_error_result(error)
            # result 中区分成功、可恢复错误、结果未知等状态
            history = adapter.append_result(history, call.id, result)

    return {"status": "budget_exhausted"}
这里最容易漏掉的是调用 ID:一次响应可能包含多个调用,结果必须与各自的请求关联,不能只追加一句没有归属的“成功”。不同接口对消息角色、响应项和继续请求有不同要求,不能把这个教学结构直接当作通用 API 协议。
这个骨架也没有实现完整的可靠性控制。真正落地时,执行入口还要负责每轮调用数、时间和费用预算;schema 错误可按策略有限反馈,权限拒绝要中止对应操作。编程缺陷应上报,不能统统变成可重试错误。副作用操作超时要标记“结果未知”,查询真实状态后再决定后续动作。max_rounds 不限制一轮内的调用数量,也不会中断一个阻塞函数。
6.3 我的疑问:JSON 更复杂,为什么反而说它可靠?
这个质疑值得保留。不能从调用侧代码变短,就推断模型生成变简单了。更准确的比较要拆成三层:
- 约定格式:提示词要求模型输出 JSON,只是一种约定,模型可能违反。
- 校验结构:JSON 解析器检查语法,schema 校验器进一步检查字段、类型和约束。发现错误不等于自动修好了错误。
- 受约束生成:部分接口提供严格结构化输出,能在支持范围内约束生成。是否启用、支持什么 schema,以及拒绝或输出不完整时如何处理,都要查对应接口。
因此,不能把“原生 Tool Calling”一概理解成“必然严格符合 schema”。例如 OpenAI 文档把 JSON 模式与启用 strict: true 的结构化输出作了区分;有效 JSON 与符合指定 schema 不是同一个保证。参见 Function Calling 官方说明。
结构化接口的价值,是让程序更明确地识别工具名称、多个参数、调用与结果的对应关系,并减少自行设计文本协议的负担。它减少了哪类错误,需要看约束实际覆盖了什么,不能只看输出长什么样。
6.4 参数格式对了,为什么任务还是可能错?
假设用户要求查询北京天气,模型生成:
{"city": "Tokyo", "date": "2026-09-13"}它可以是合法 JSON,也可以完全符合 city、date 都是字符串的 schema,却仍然违背用户要求。schema 能检查字段结构,不会自动理解并证明业务意图正确。

图 6:每一关解决不同问题。字段合法、拥有权限、执行成功和任务完成,不能合并为一个 ok。检查程序也有覆盖范围,不能当成无所不知的裁判。
| 检查层次 | 能回答的问题 | 仍然不能保证什么 |
|---|---|---|
| 语法与 schema | 参数能否解析,必需字段是否齐全? | 选对城市、文档和业务对象 |
| 业务与权限 | 对象是否允许访问,动作是否在授权范围? | 工具自身一定正常 |
| 工具执行 | 请求是否实际完成,有没有失败或未知状态? | 返回内容一定准确 |
| 任务验收 | 实际产物是否满足可检查的要求? | 开放任务所有语义都已被证明 |
能确定的条件尽量交给程序,例如对象 ID 是否属于当前用户、日期是否在允许范围内。无法确定的语义不能假装已经验证,可以通过检索证据、澄清或人工检查处理。也不能把模型生成的一段“执行成功”当作真实工具回执。
6.5 MCP、Runtime、Harness 应该接在哪里?
我的另一个困惑是:是不是有了 MCP,前面这个循环就不需要了?实际上,MCP 提供主机、客户端和服务端之间的连接与能力交互协议,包含工具、资源和提示词等概念。它不自动决定下一步任务,也不替代权限和结果验收。参见 MCP 架构说明。
在这个例子中,执行器可以调用本地函数、HTTP 服务,或者通过 MCP 客户端调用远端工具。使用 MCP 时,还需要把发现的工具定义适配给模型接口,并处理调用结果。Function Calling 与 MCP 可以配合使用,也可以各自存在。
Runtime 通常指负责循环、工具执行、状态和生命周期的运行环境;Harness 常被用来描述围绕模型的工具、上下文、约束与评测设施。两者用法有重叠,不是业内统一规定的两个独立组件。
因此,前面的几十行代码已经承担了一部分运行时工作。后来引入框架,是把这些责任显式拆开并完善,不是多叠几个名称,系统就自动变可靠。更完整的讨论可以看 Agent 架构、工具与执行。
6.6 Memory 是不是就是把 history 保存下来?
history 是本次请求可见的工作上下文。把它持久化,可以帮助恢复会话,但不等于完成了长期记忆设计。任务状态、原始执行记录、需要跨任务保留的知识,也不必全部放进下一轮提示词。
我的理解是:先保留可追溯的执行记录,再按需要选择相关信息进入上下文。准备存成长期记忆时,还要判断来源、适用范围、时效和冲突。一次错误尝试可以作为经历记录,却不应该未经验证就变成“以后必须这样做”的规则。
即使失败后再调用模型写一段总结,也不能仅凭这个动作就宣称复现了 Reflexion;还要看反馈、记忆与后续尝试如何组织。外部检索和记忆内容同样不应获得覆盖用户要求或权限约束的地位。详细设计见 上下文、记忆与多 Agent。
经过这些追问,我更愿意把工具调用看成一份待执行的行动提议。结构化接口让这份提议更容易被程序接收和检查;真正的可靠性仍来自明确的约束、真实的反馈和针对任务的验收。我评价一种封装时,会先问它减少了哪类失败,而不是只看调用侧缩短了多少行。
7. 再看这段代码:哪些地方还不能直接用于实际服务?
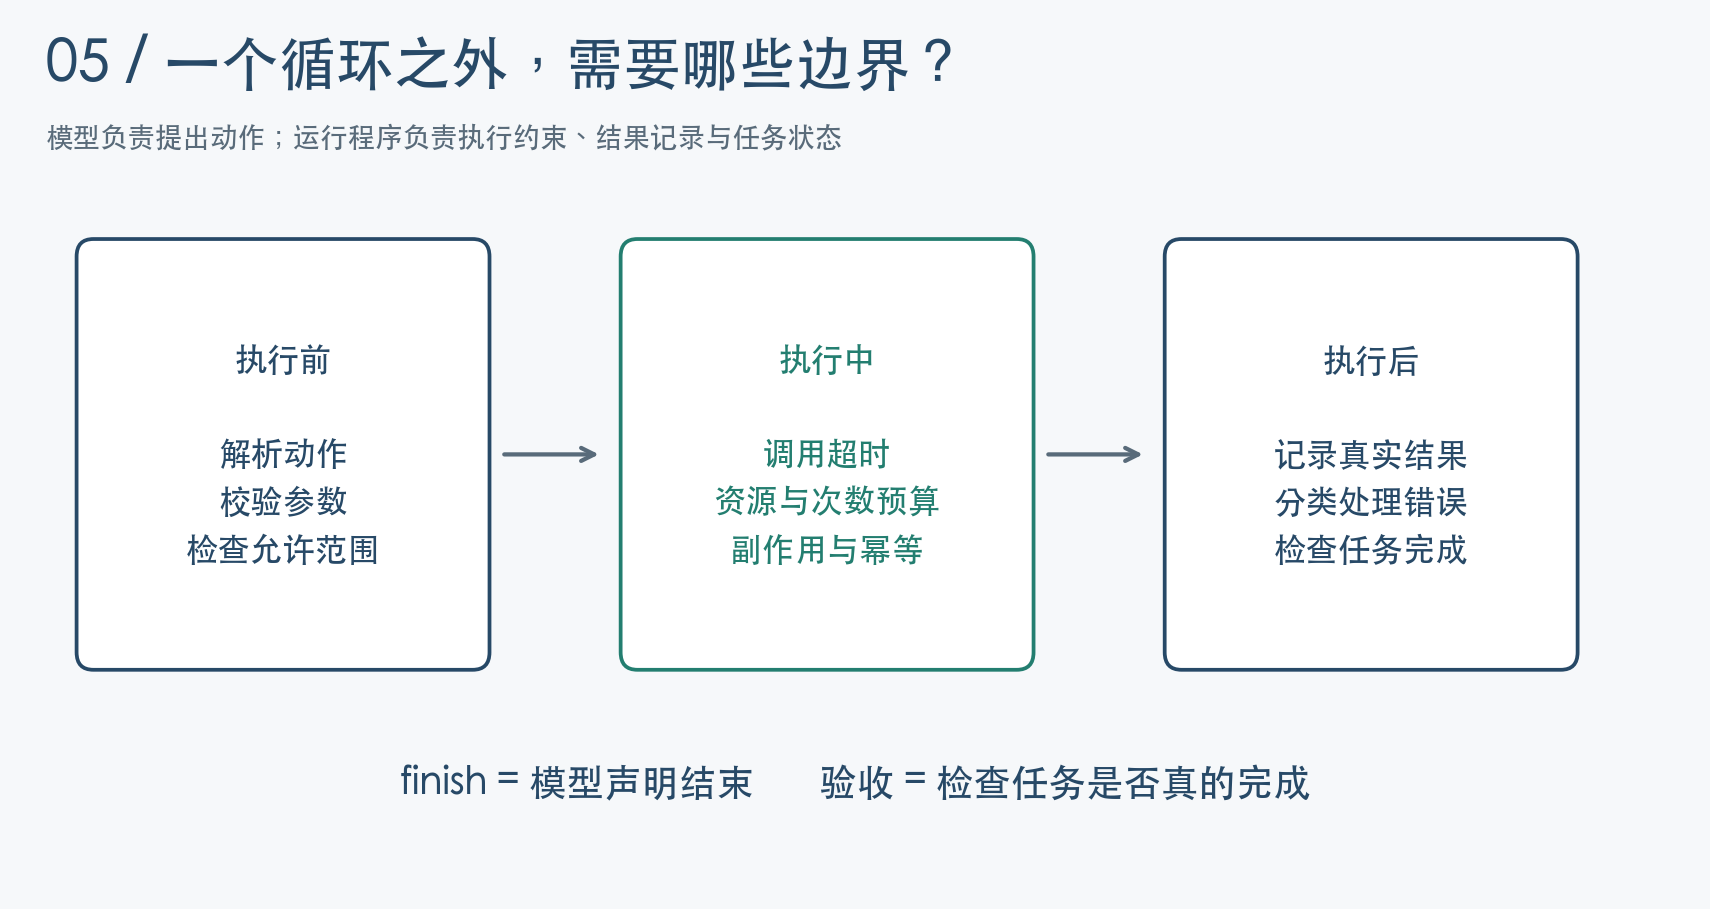
图 7:执行前校验、执行中约束、执行后记录与验收。循环不是完整系统,运行程序还要承担明确的控制责任。
| 容易踩的坑 | 为什么会发生 | 改进方向 |
|---|---|---|
| 模型写出假的结果 | 文本续写可能模仿完整轨迹 | 运行程序单独写入工具结果,记录调用来源 |
| 动作解析错误 | 方括号嵌套、多动作、格式漂移 | 明确 schema、严格校验、有限修复 |
| 工具报错后原地重试 | 错误没有分类,策略未改变 | 区分参数、网络、权限与程序缺陷 |
| 无限或重复行动 | 下一步没有带来新信息 | 步数预算,加结果与进展检查 |
| 单次调用一直阻塞 | 步数限制不会中断当前函数 | 工具超时与任务总时限 |
| 长历史超出预算 | 只截断单条结果,历史仍累积 | 总 token 预算、选择相关片段、必要时摘要 |
| 模型过早结束 | 结束动作被当作任务成功 | 根据任务定义检查实际结果 |
[:512] 限制的是字符数,不是 token 数;摘要也可能遗漏关键证据,不必每次都再启动一个 Agent。优先让工具返回相关、紧凑且带来源的字段。
异常处理同样需要边界。临时网络错误可以有限重试,参数错误可以反馈修改;权限错误不应靠反复尝试绕过。程序缺陷需要记录和处理,而不是一律交给模型。直接回传完整异常还可能暴露内部路径或凭证。
涉及有副作用的工具时,超时尤其需要谨慎:没有收到响应,不代表操作没有完成。是否重试,应结合结果查询和幂等机制。重试次数有限,并不能消除重复执行的后果。
8. 从骨架到可运行演示:先验证控制流程
随本文提供的 react_demo.py 使用本地模拟模型与资料库,无需 API Key,也不执行任意 Python。它通过 JSON 表达动作,校验名称和参数,并测试四种路径:正常完成、未知工具后恢复、解析失败达到上限、步数耗尽。
python3 react_demo.py核心交接仍然很短:
raw = model(history)
action = validate_action(raw)
result = tools[action["tool"]](action["arg"])
history.append({"role": "tool", "content": result})
完整实现还处理终止和异常。模拟模型按预定步骤输出,因此演示只能证明运行程序按预期流转,不能证明真实模型会规划或从错误中恢复。这里的消息角色也是教学数据结构,不声称兼容某家 API。
接入真实服务时,还需要模型适配器、工具超时、上下文预算、权限限制与任务验收。这里的 JSON 只是自行约定的动作格式,不是原生 Tool Calling,也没有启用受约束生成。解析和校验能发现部分错误,不能保证真实模型选对工具或参数。
9. 我的反思:ReAct 真正厉害的是什么,什么时候值得用?
读完代码后,我最看重的已经不是三个标签,而是:任务尚未完成、信息尚不充分时,系统可以通过行动获取证据,再改变下一步决策。
排查博客图片不显示就是一个合适的例子。开始时可能怀疑路径、访问控制或者 HTTPS。检查请求后,如果发现证书过期,后续就应该检查证书配置,而不是继续机械修改图片地址。
这不是说 ReAct 发明了反馈控制。它提供的是一种用语言模型组织推理和环境交互的方法。模型不必在开始时猜中整个过程,但每次交互都应该对任务有帮助。
我会用三个问题决定是否采用这种循环。
第一,是否缺少必须从外部取得的信息? 当前运行状态、真实文件和测试结果,不能靠模型自行补全。
第二,反馈是否会改变下一步? 如果步骤完全固定,普通脚本通常更直接。需要外部信息但只需固定查询一次,也未必需要多轮 Agent。
第三,结果是否可观察,试错成本是否可控? 可读取、可测试的任务更容易形成有效反馈;不可逆操作需要额外执行限制。
| 场景 | 我会优先考虑 |
|---|---|
| 材料齐全,只需总结或改写 | 直接模型调用 |
| 固定步骤的数据处理 | 脚本或固定工作流 |
| 路径不确定的故障排查、资料核实 | ReAct 式交互 |
| 有明确测试的代码修改 | 受约束的执行与反馈循环 |
| 后果重大且难以验证的操作 | 严格工作流与必要人工决策 |
所以我不会用“工具调用次数多”评价一个 Agent。更值得检查的是:每次行动有没有减少不确定性?失败后有没有改变策略?证据充分时有没有及时停止?
10. 面试复盘:我应该能讲清楚的六个问题
ReAct 和 function calling 是什么关系?
ReAct 描述推理与行动的组织方式,function calling 描述结构化工具调用接口。工具调用能力本身不构成完整循环,仍需要运行程序执行并回填结果。MCP 等工具连接协议也处于不同层次,不自动负责规划和验收。
追问:只调用一次工具算 ReAct 吗? 不能仅凭次数判断,要看方法定义和实际组织方式;不要把所有工具调用统一贴上 ReAct 标签。
stop 能防止模型幻觉吗?
它可以控制特定字符串处的生成边界,不能保证事实、参数或结果正确。真正的工具结果应由程序记录,输出合法性另行校验。
追问:换成 JSON 就安全了吗? 有效 JSON 只说明语法可以解析;schema、业务语义、参数权限、工具行为和不可信内容仍需分别处理。
为什么把错误作为 Observation?
对于可恢复错误,反馈能让模型调整参数或策略。但程序仍负责重试次数、超时和权限,不是所有异常都适合交给模型。
追问:付款接口超时,直接重试可以吗? 不能先假设付款失败,要查询实际结果并保证幂等性。
为什么 max_steps 不够?
它限制循环次数,不限制单次工具阻塞、单步成本或累计上下文。还需要时间、token 和工具预算。
追问:重复调用一定是死循环吗? 不一定,例如状态轮询可能合理;要结合时间、结果变化和任务目标判断。
ReAct 为什么可能不如直接回答?
交互增加信息来源,也增加查询和执行失败的机会。信息已经充分或流程固定时,额外循环未必有收益。
追问:怎么验证使用价值? 在相同任务集上比较成功率与成本,并分析失败原因;不要仅展示一条成功轨迹。
finish 和任务成功有什么区别?
前者是模型的结束声明,后者要根据任务验收。例如修复代码应检查测试和实际行为,不能只相信“已经修好”。
追问:开放问答怎么验收? 按任务要求检查证据、引用和答案一致性,无法确认时保留不确定性。
读懂这段循环后,我希望自己能同时解释两件事:模型依据什么决定下一步,以及程序如何确保这个动作确实按约束执行。把这两层分开,才更容易定位问题,也更容易判断什么时候不需要 Agent。
参考资料
- Yao et al. ReAct: Synergizing Reasoning and Acting in Language Models. ICLR 2023. 论文 · 项目与代码。本文实验图对应 Table 1。
- Shinn et al. Reflexion: Language Agents with Verbal Reinforcement Learning. 论文。
- HotpotQA 官方 评测实现。
说明:本文由我的学习对话整理,并结合原论文与代码检查修订。示例轨迹为教学模拟,配图为重新绘制;尚未对真实模型进行本文任务的性能复现。