最初接触 Function Calling 时,我以为模型获得了执行函数的能力。读到 JSON Schema、结构化输出和并行工具调用之后,我才逐渐把两件事分开:模型提出调用,程序负责执行。
于是,一个比“参数能不能输出成 JSON”更重要的问题出现了:模型把参数写对之后,离正确完成任务还有多远?
这篇沿着一个文档助手展开:搜索资料、读取文档、整理报告。上一篇 ReAct 讨论行动与反馈的循环;这里把循环中的工具调用放大,看看每个环节到底负责什么。
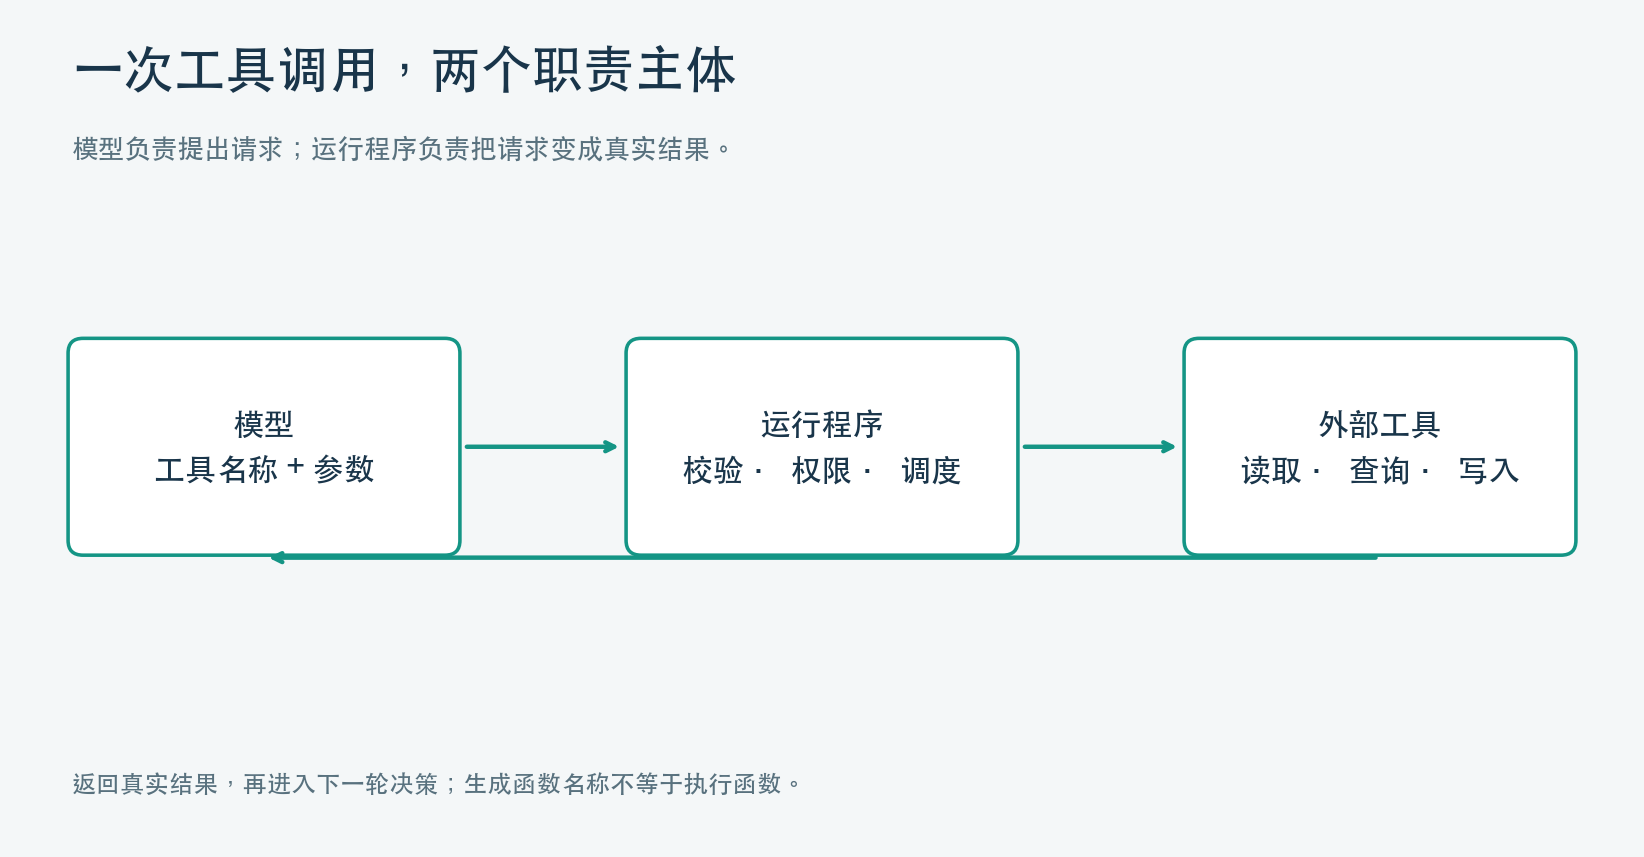
图 1:模型产生调用请求,运行程序把请求变成受控的外部操作,再把结果交还模型。
1. 模型输出的是调用请求
以客户端工具为例,模型可以输出“调用 search_documents,查询 ReAct,最多返回 5 条”。宿主程序(host)收到请求后,从工具注册表找到真正的函数,验证输入并执行。模型本身并没有因为生成了函数名称,就自动运行本地 Python。
平台托管的服务端工具可以由平台完成执行,但执行责任仍然落在具体系统中。理解这一点,才能知道失败应该去哪里排查。
| 概念 | 在这条链路中的作用 |
|---|---|
| Tool Use,工具使用 | 利用外部能力获取信息或完成操作 |
| Function Calling,函数调用 | 用接口约定表达函数名称与参数 |
| Tool Calling,工具调用 | 工具请求机制;不同平台对工具范围和消息格式的定义不同 |
| JSON Schema,JSON 模式 | 声明输入或输出的数据结构与约束 |
| Structured Outputs,结构化输出 | 接口提供的结构约束输出能力,具体支持范围依平台而定 |
| ReAct | 根据行动结果继续决策的交互方式 |
这些概念不是一条升级路线。ReAct 可以使用原生工具调用接口;结构化输出也可以用于最终答案,而不调用任何工具。Function Calling 与 Tool Calling 在许多文档中有重叠,用到具体 API 时再确认精确定义。
2. JSON Schema:数据与数据规则有什么区别?
JSON Schema 通常译为“JSON 模式”,可以先把它理解成一份数据规则说明书。JSON 是实例,Schema 描述实例应当满足什么条件。
例如,文档搜索工具的参数是:
{"query": "ReAct 工具调用", "max_results": 5}对应的一份 Schema 可以写成:
{
  "type": "object",
  "properties": {
    "query": {
      "type": "string",
      "minLength": 1,
      "description": "待检索的主题,保留用户的关键术语"
    },
    "max_results": {
      "type": "integer",
      "minimum": 1,
      "maximum": 10,
      "description": "最多返回的文档条数"
    }
  },
  "required": ["query", "max_results"],
  "additionalProperties": false
}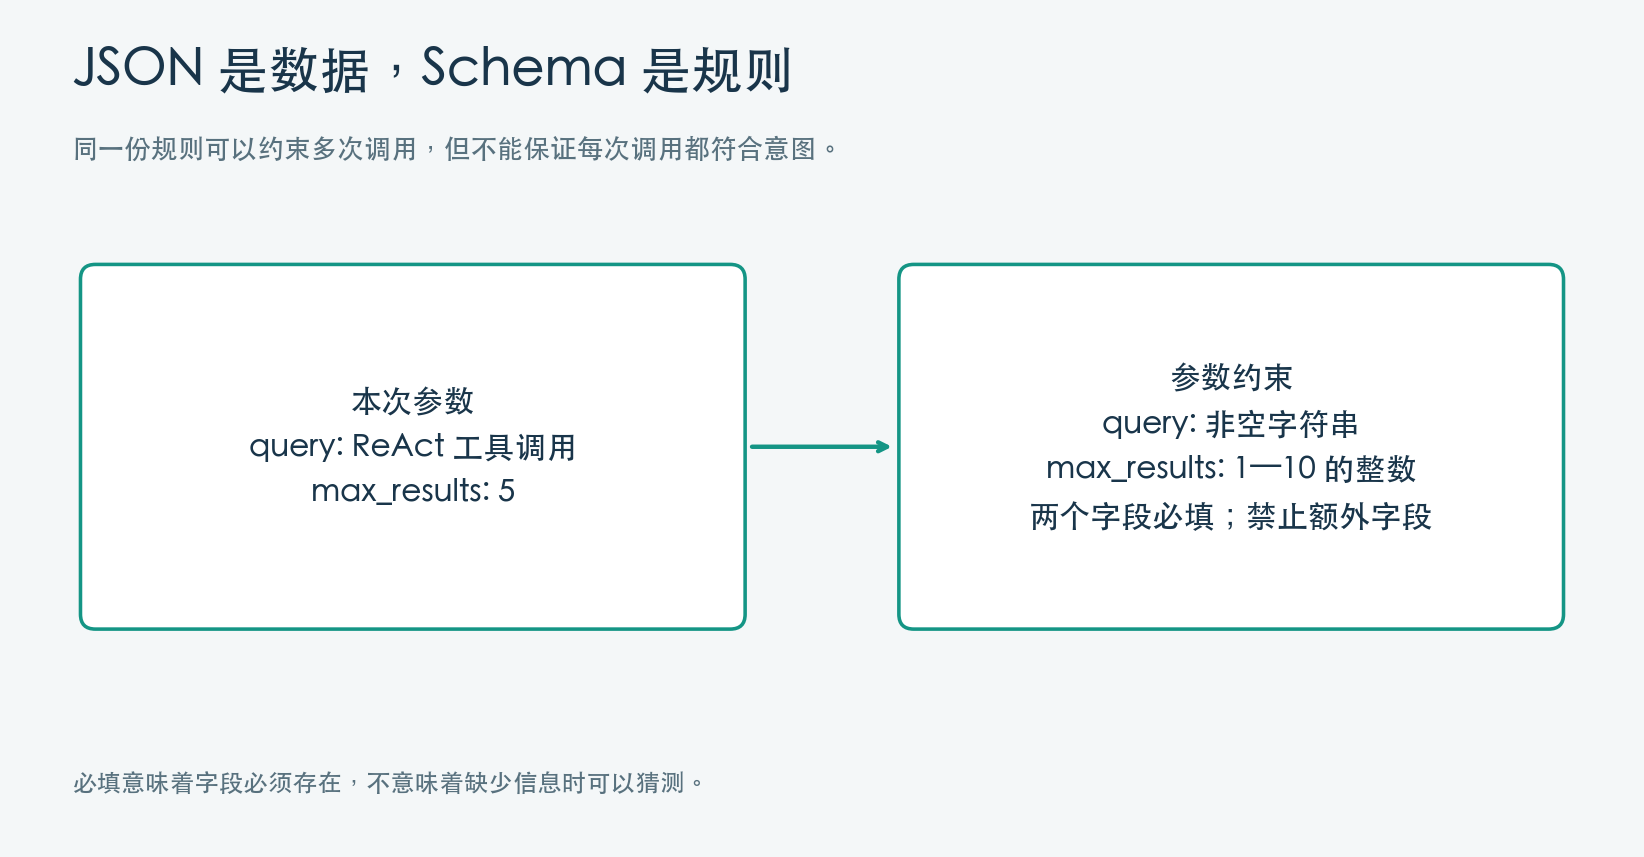
图 2:参数回答“这次传什么”,Schema 回答“允许传什么”。它并不证明搜索主题符合用户意图。
properties 声明字段,required 要求字段存在,additionalProperties: false 禁止未声明的字段。仅把字段写进 properties,并不自动要求它出现。JSON Schema 对象规则
三个细节值得记住。第一,必填不意味着允许模型猜测;缺少必要信息时应澄清或通过可信工具获取。第二,字段缺失和 null 是不同的数据状态,但各自的业务含义由接口约定。第三,default 是注解,普通校验并不会自动按它补齐缺失值。JSON Schema 注解
日期也类似:正则匹配到“年-月-日”的形状,不等于日期真实存在;format 是否作为强制断言执行,要看规范方言和校验器配置。JSON Schema 验证规范
Schema 是声明,不是主动执行的程序。解析器读取 JSON,校验器检查实例,支持约束生成的系统则可以利用规则限制生成过程。
3. 合法参数不等于正确任务
我曾把“输出能解析”当成工具调用已经基本解决。实际上一段能解析的 JSON,仍然可能调用错工具、搜索错主题,或者访问了无权读取的文档。
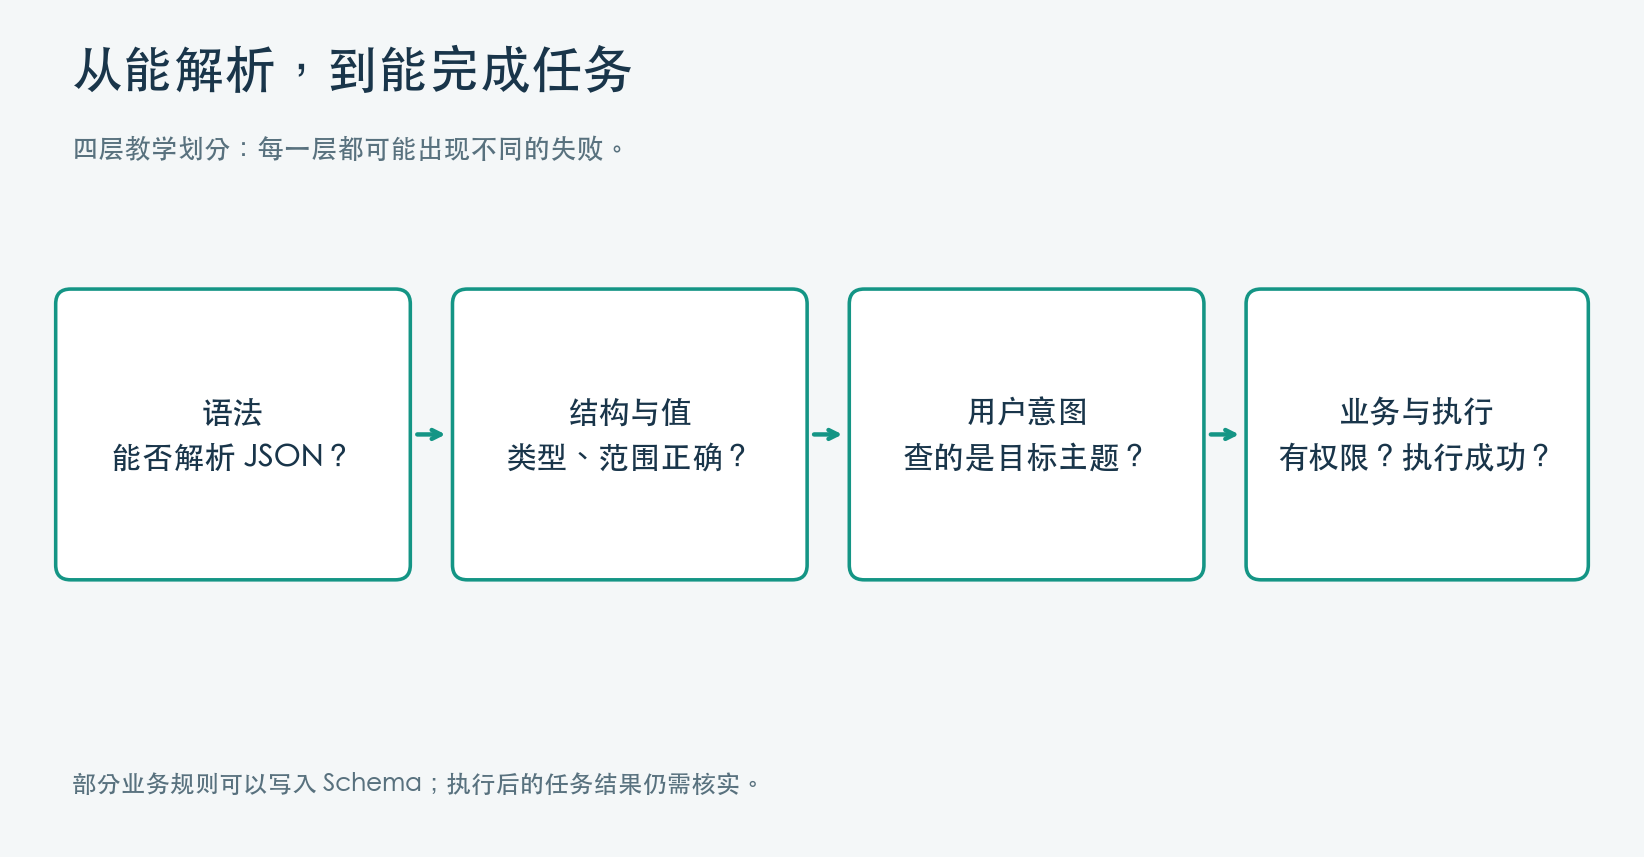
图 3:这是理解错误来源的教学划分,实际约束可以跨层;执行完成后还需要检查结果是否满足任务要求。
| 检查 | 文档助手中的失败 |
|---|---|
| 语法 | 少了引号,无法解析 |
| 结构与值约束 | max_results 传字符串,或超过允许范围 |
| 意图 | 用户问 ReAct,查询却变成 Reflexion |
| 业务与执行 | 文档不属于当前用户,或存储服务超时 |
Schema 能表达的范围不止字段类型,也能表达范围和部分条件关系。可是,用户究竟要找什么、当前身份能不能读某文档、外部服务是否可用,不能普遍靠一份 Schema 保证。
结构约束生成的直观理解是:在生成过程中排除不符合受支持规则的候选。它与“先生成,再解析,失败后重试”发生在不同阶段。两者也能组合:生成时减少格式错误,执行前仍做校验。具体平台支持哪些 Schema 关键词、是否支持严格工具参数、如何处理拒绝或截断,都要按实际接口核对,不能把某个版本的能力当成通用定律。
我现在会把结构化输出看成减少一种不确定性的办法,而不是一次调用的成功证明。
4. 工具接口也是给模型看的接口
文档助手最开始可以只有三个工具:search_documents、read_document、save_report。它们的边界比一个万能 process(data) 更容易描述和验证。
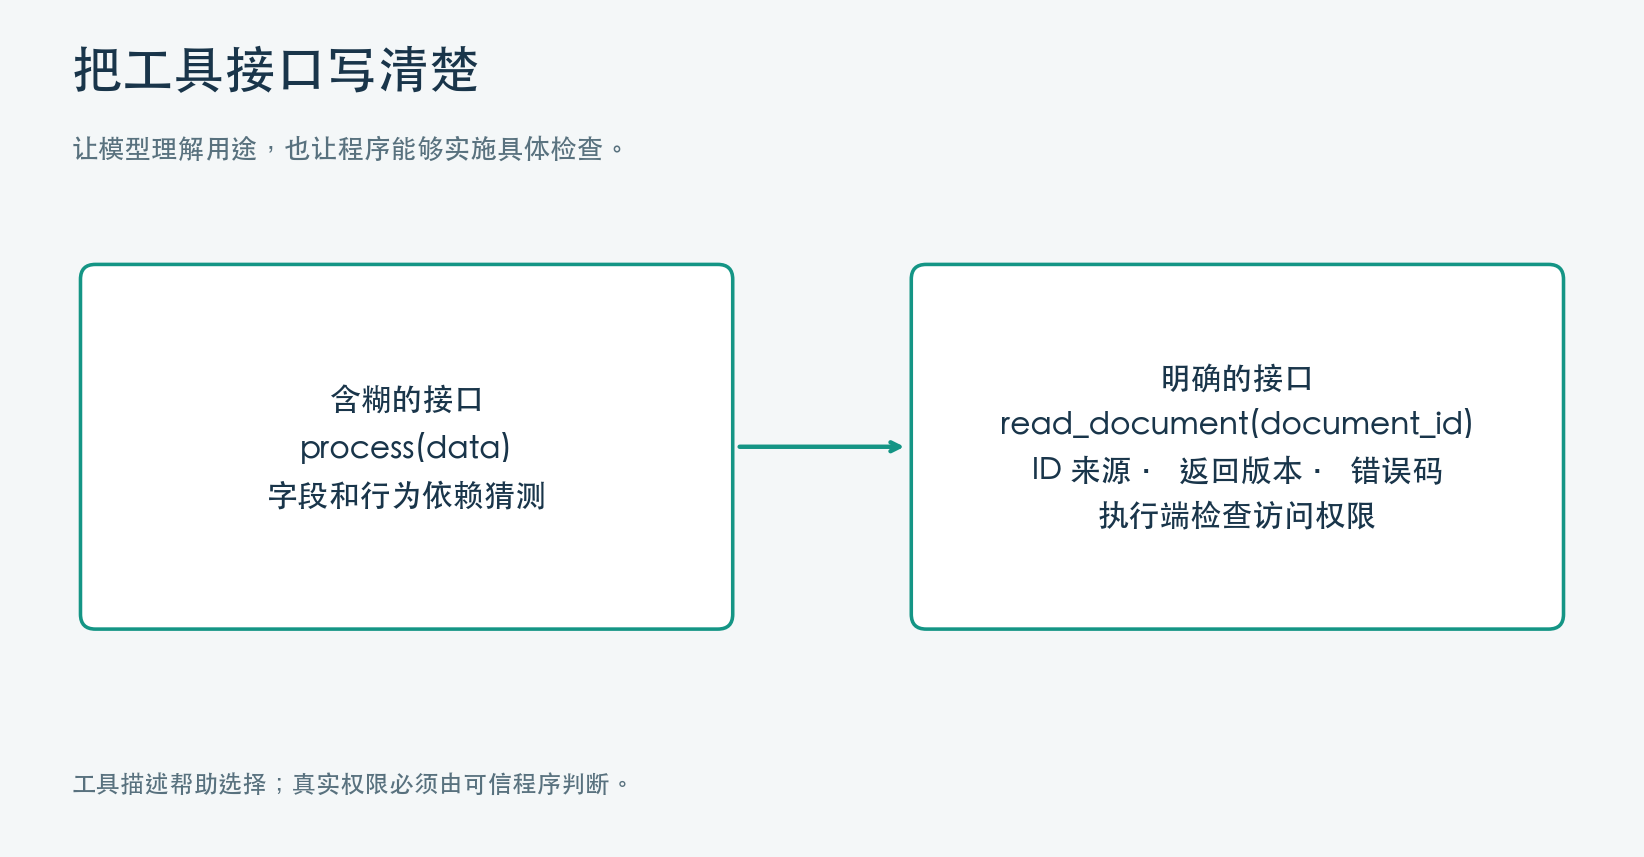
图 4:更清晰的工具契约同时帮助模型选择与程序验证;工具描述不是权限控制器。
4.1 名称与参数要能解释用途
搜索工具应说明查询对象、返回条数、返回字段。读取工具应说明 document_id 来自搜索结果或其他可信输入。保存工具需要定义覆盖规则、目标位置和版本条件。
参数描述不是装饰。含糊的 value 很难说明是数量、金额还是时间;timeout_seconds 比 timeout 更清楚。单位、范围和错误行为都应明确。
4.2 身份与授权不要交给模型自证
当前用户和租户通常来自认证上下文。模型提供的文档 ID 仍需检查访问权限;模型输出 is_authorized: true 不构成授权证据。
如果保存操作需要确认,应由程序检查真实的确认记录及其对应操作。描述中写“危险操作请谨慎”可以提示模型,但不能替代执行端规则。
4.3 返回值要保留可用证据
读取结果可以包含 document_id、version、正文和来源。失败结果可以包含稳定错误码、简短说明以及是否允许重试。应避免把数据库连接信息、密钥或完整内部堆栈直接回给模型。
大文本可以按章节读取、选择相关片段或摘要。摘要需要保留来源定位,以便回查;结构化包装本身并不保证节省 token。
工具结果中的文档正文是外部数据,即使出现“忽略前面的要求”,也不应因此获得系统指令的权限。
5. 从一次调用到并行工具使用
5.1 一次调用的生命周期
调用请求里至少要能辨认工具、参数和调用 ID。程序检查请求,执行工具,再将结果关联到同一次调用。调用 ID 解决“这是谁的结果”;业务幂等键解决“重复提交是否会重复产生业务效果”。两者用途不同。
下面使用 Claude Messages 的客户端自定义工具格式:保留 assistant 返回的内容,再紧接着回传关联的 tool_result。其他 API 的消息角色和字段可能不同,不能直接混用。客户端工具结果协议
5.2 多个调用,不一定同时执行
模型在一次响应中提出多个工具请求,只表示它提出了一个批次。调度程序还要判断参数是否已经就绪、是否共享可变状态,以及执行是否被允许。
搜索结果尚未返回时,读取工具拿不到真实文档 ID。简单把两个请求放进 gather 没法解决这个依赖;甚至改成顺序执行也不够,因为第二个请求的参数可能已经错误,需要重新构造或重新决策。
5.3 并行的基本单位是当前已经就绪的任务
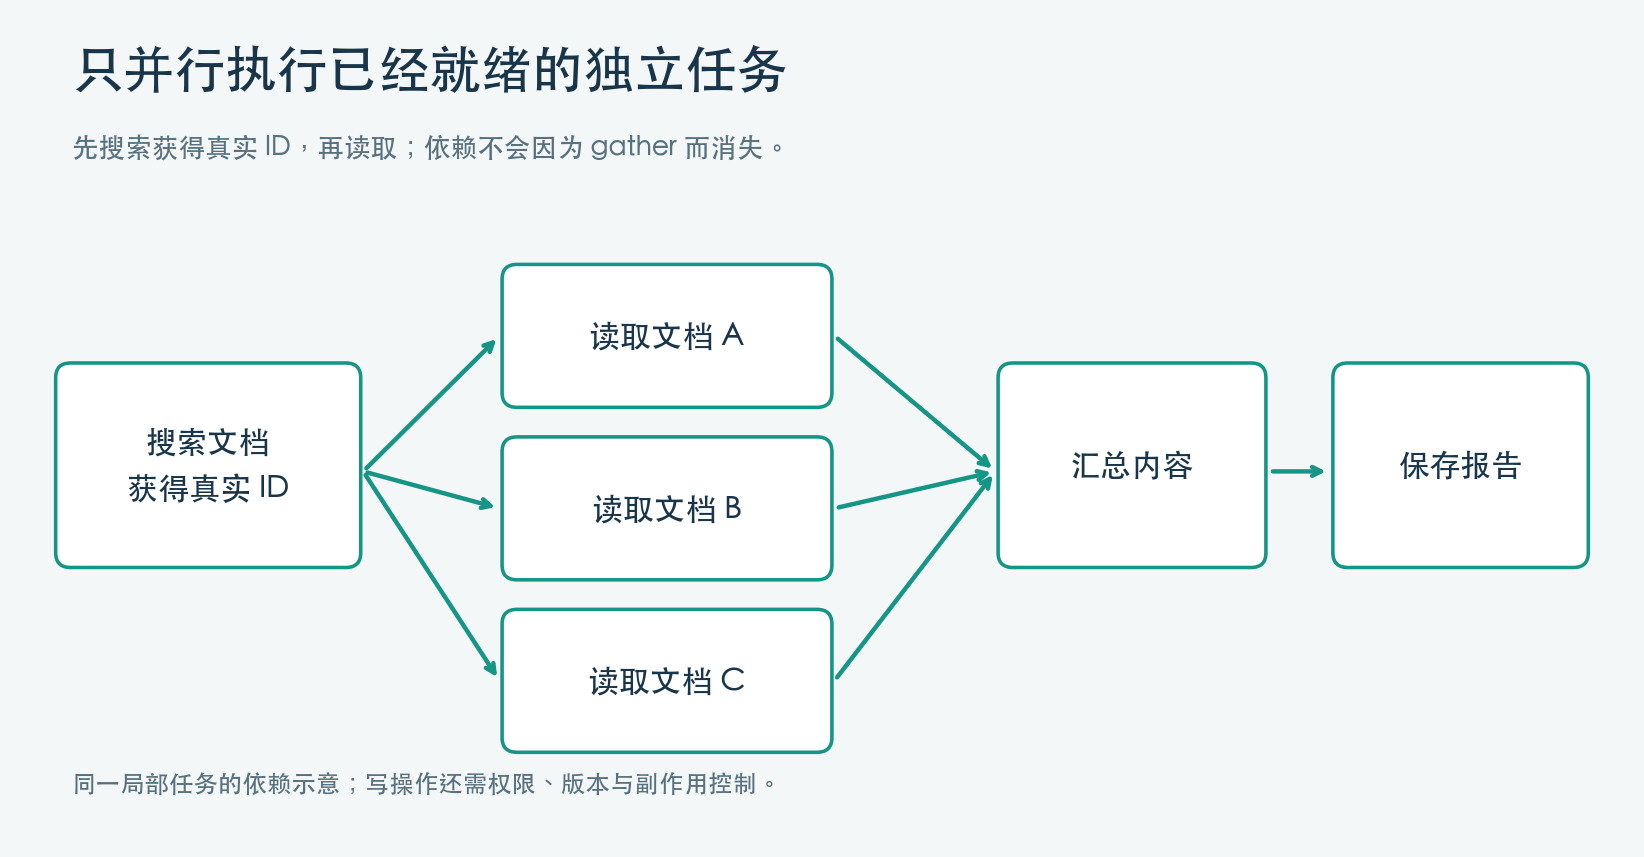
图 5:先搜索获得真实 ID,再并行读取独立文档;汇总依赖读取结果。图是一次任务的局部依赖,不要求整个 Agent 循环无环。
同一批已知 ID 的独立读取通常可以并行。如果两个操作修改同一份报告,就要考虑版本检查、事务或串行调度。工具是否幂等主要影响重复执行的语义;判断并行还需要看数据依赖和状态冲突。
减少一段独立读取的等待时间,不等于减少所有成本。多个查询会增加请求量,汇总也要消耗上下文。是否值得并行,应看整个任务的完成时间和质量。
5.4 Parallel Tool Use 的注意点
下面是 host 端教学伪代码,采用 Claude Messages 风格。它只处理一轮已完整返回的普通客户端工具调用,不处理流式片段、服务端工具或完整 Agent 循环。
validate_batch、execute_tool 和 safe_error 是项目需要实现的边界:前者验证名称、参数、权限和批次独立性;dispatcher 运行真实异步工具;错误转换器只暴露允许公开的信息。示例未连接真实模型,不能作为完整生产代码直接运行。
import asyncio
import json

async def parallel_tool_step(client, model, conv, tools):
    response = await client.messages.create(
        model=model, max_tokens=2048,
        messages=conv, tools=tools,
    )
    # 截断、拒绝等情况交给外层处理,不执行不完整调用。
    if response.stop_reason not in {"tool_use", "end_turn"}:
        raise RuntimeError("response_not_complete")

    calls = [b for b in response.content if b.type == "tool_use"]
    assistant = {
        "role": "assistant",
        "content": [b.model_dump(mode="json") for b in response.content],
    }
    if not calls:
        conv.append(assistant)
        return []

    # 不通过则本轮不执行;交给外层报告拒绝或重新规划。
    # 不能只看模型描述就认定独立,要使用可信工具契约与任务状态。
    validate_batch(calls)
    semaphore = asyncio.Semaphore(4)

    async def run_one(tc):
        try:
            async with semaphore:
                data = await asyncio.wait_for(
                    execute_tool(tc.name, tc.input), timeout=15
                )
            payload, failed = {"ok": True, "data": data}, False
        except asyncio.CancelledError:
            raise
        except Exception as exc:
            payload, failed = safe_error(exc), True
        return {
            "type": "tool_result",
            "tool_use_id": tc.id,
            "content": json.dumps(payload, ensure_ascii=False),
            "is_error": failed,
        }

    # 独立读取采用部分失败策略:每个调用分别回传成功或错误。
    results = await asyncio.gather(*(run_one(tc) for tc in calls))
    conv.extend([assistant, {"role": "user", "content": results}])
return results模型倾向于并行,不代表工具实际上可以并行。一种便于落地的做法,是为当前步骤只开放已经满足前置条件的工具,并在执行端检查具体批次。仅按工具名称分组也不充分:同一种工具的两个参数可能指向同一个可变资源。
这段代码选择保留独立调用的部分成功结果。每个任务内部转换普通异常;如果直接使用默认 gather 而不处理异常,第一个异常会向调用者传播,其他任务不会因此自动全部取消。返回结果按输入任务顺序排列,并通过 ID 明确关联。Python asyncio 文档
信号量在这里限制本轮同时执行的数量。服务级并发限制需要共享配额控制;每分钟请求限额还需要速率策略。15 秒超时也只针对单次执行,不包含完整任务的排队、模型推理和后续轮次。
对于写操作,超时后应先确认外部状态或利用业务幂等机制,再决定是否重试。取消本地等待并不会自动撤销已经提交的写入。
6. 出错后,怎样继续才有意义?
遇到错误时,关键不是统一重试三次,而是区分错误是否可恢复。
| 情况 | 合理处理方向 |
|---|---|
| 参数不合法 | 返回可理解的校验错误,有限次数修正 |
| 权限不足 | 阻止执行,说明权限条件;不能重试绕过 |
| 文档不存在 | 检查 ID 来源,必要时重新搜索 |
| 限流或短暂不可用 | 根据服务提示、总预算和退避策略重试 |
| 写入结果不确定 | 查询状态或按幂等协议确认,避免重复副作用 |
| 一直重复无效查询 | 检测无进展,换策略、澄清或结束 |
把错误回给模型,是为了让它获得决策依据,不是保证它一定能够恢复。外层仍需设置轮数、总时间、费用预算和终止条件。任务完成也不能只看模型说“好了”:保存报告要能检查目标文件、版本和必要内容是否确实存在。
7. 我的思考:工具调用真正改变了什么?
7.1 从“模型说了什么”转向“程序能核实什么”
学习 Schema 之前,我更关注输出长什么样。现在我更愿意沿着链路问:参数由谁验证,身份从哪里来,结果能否回查,失败后哪些操作已经发生?这些问题比记住一个 SDK 方法名更接近工具使用的本质。
结构化调用提供了明确的检查入口。它把含糊的“帮我操作一下”拆成可审查的请求,但请求依然可能错。真正的收益来自模型表达与程序约束能配合起来。
7.2 工具越多,越需要限制当前选择空间
工具数量增加,不代表任务一定更容易完成。我倾向于按当前任务阶段提供相关工具,让参数来源和前置条件清楚可见。这里的限制不是让系统失去能力,而是避免模型在不合适的时候选择尚不可执行的操作。
是否需要这种设计,还应通过任务集比较:工具选错率、参数修正次数、最终成功率、延迟和成本。没有实际数据时,我会把它写成设计判断,而不是已经验证的优化成果。
7.3 并行优化的是任务,不是调用数量
对同一组资料,顺序读和并行读可以比较;但如果并行方案额外查了大量无关文档,单看某一步更快就没有意义。我更关心成功完成一次任务需要多少等待、多少失败恢复和多少费用。
这也让我重新理解 ReAct 与 Reflexion:ReAct 让系统根据当轮反馈继续行动,Reflexion 尝试把失败经验带入后续尝试;Tool Use 则决定每次行动如何接触真实环境。三者可以结合,但可靠的执行边界不能被任何一层省略。
8. 面试时,我会怎样解释?
“Function Calling 是怎么工作的?” 模型按接口提出工具名称和参数,程序校验并执行,再按协议把结果关联回调用,模型据此继续。具体工具也可能由平台托管,但总有执行方负责实际操作。
“有了 JSON Schema 为什么还要验证?” Schema 能约束结构与部分值规则;权限、意图和外部状态需要额外判断,生成失败或接口支持差异也需要处理。
“什么时候可以并行?” 当前参数已就绪、任务间没有必要的数据或控制依赖、共享状态没有不可接受冲突,并且资源与权限允许。幂等不能单独证明这些条件。
“工具失败后怎么办?” 先区分校验错误、业务拒绝、临时错误和结果不确定,再决定修正、退避、查询状态或终止。不能把所有失败都当作安全重试。
技术资料核对:2026 年 9 月。代码为教学伪代码,未声称真实模型评测或线上部署结果;接入时以所用 SDK 与模型接口版本为准。
