读完 ReAct 后,我以为下一步很自然:让 Agent 在失败后总结一下,把经验放进下一轮,它就能越做越好。但继续追问后,我发现这里至少有三个尚未解决的问题:它真的知道自己为什么失败吗?写下来的经验可靠吗?下一次成功,又能证明多少东西?
Reflexion 值得学习,恰恰因为它把这些问题摆到了运行流程里。本文从一个双层循环开始,讨论反思如何影响行动,再回到 WebShop 的有限收益、几十行代码的边界,以及我会如何验证这种方法。
本文承接 《读懂 ReAct:从推理与行动,到一个真正运行的 Agent》。配图重新绘制;文中的短轨迹与代码案例是教学设计,不是我的线上项目经历,也不是对论文实验的复现。
1. ReAct 已经会调整,为什么还需要 Reflexion?
ReAct 的执行循环可以根据当前工具结果改变下一步。搜索结果不相关,就修改查询;工具提示参数错误,就修正参数。这些变化发生在一次尝试内部。
但一次尝试也可能结束得很糟:上下文已经很长,任务没有完成,模型还在重复一个无效动作。下一次重新开始时,如何保留值得保留的经验,而不是从头犯同一个错误?这正是理解 Reflexion 的入口。
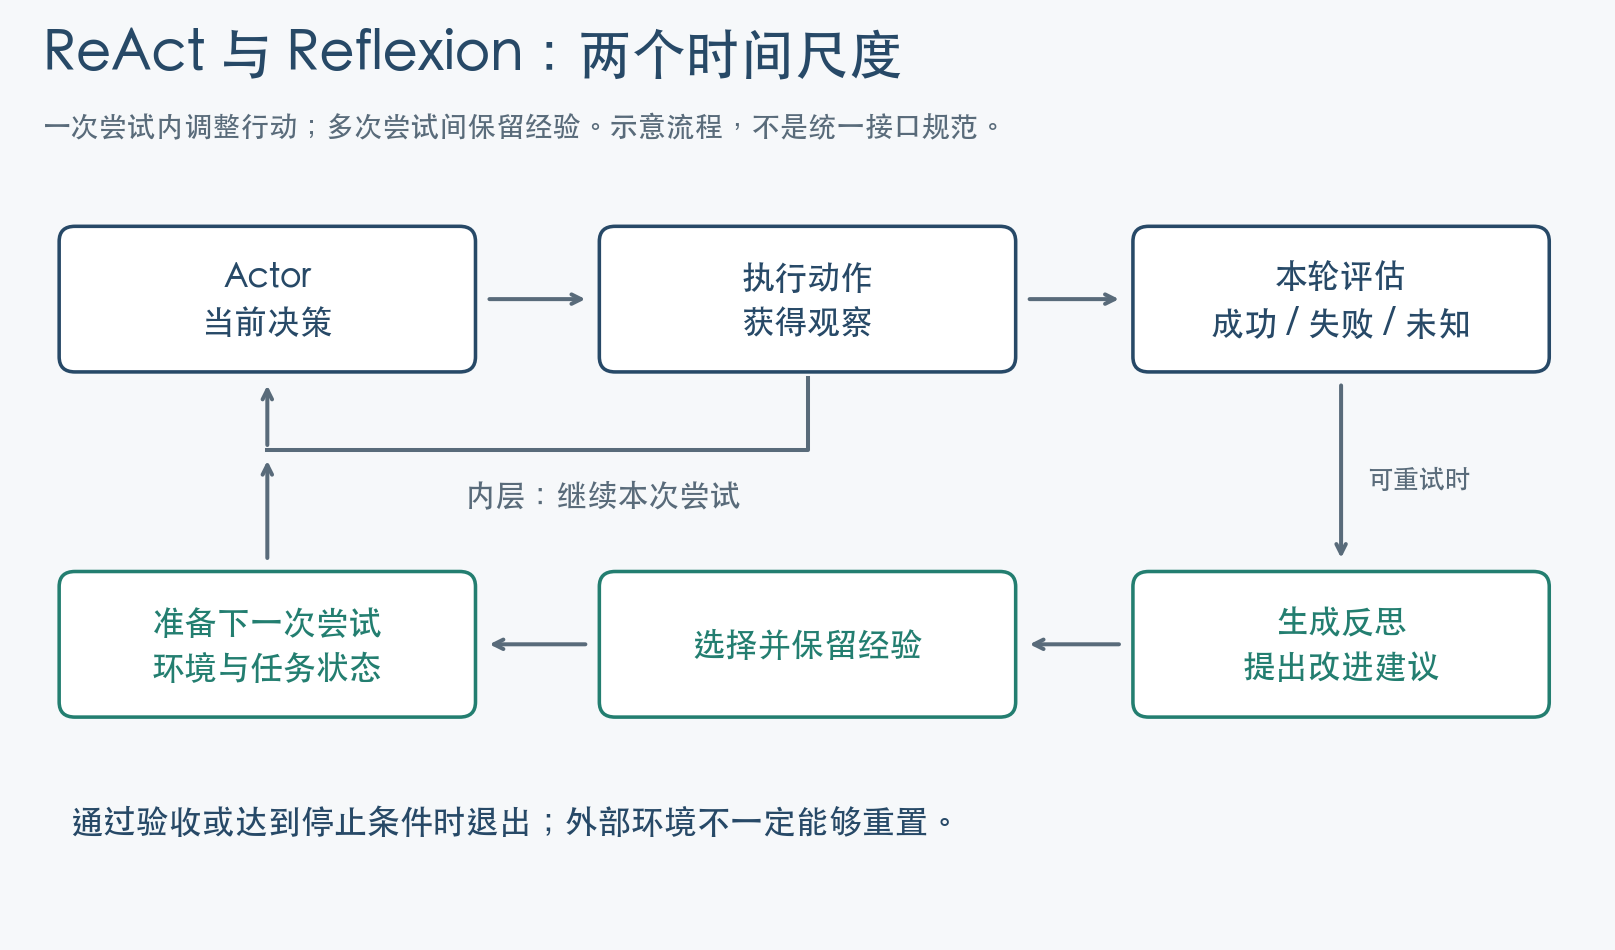
图 1:内层产生行动与观察,外层评估一次尝试并生成供后续使用的经验。图中以 ReAct 为 Actor 示例,不要求所有 Reflexion 实现都使用 ReAct。
假设任务是“核实某个软件版本是否修复了指定缺陷”。第一次尝试只看到一篇评论就宣布修复,验收发现缺少正式记录。下一次可以携带一条有针对性的提醒:“评论不能替代发布说明;提交结论前,核对版本号、缺陷编号和正式来源。”
这条提醒只有被后续执行实际使用,才可能产生价值。如果第二次仍然引用同一篇评论,只是多说一句“我吸取了教训”,循环结构看起来完整,行为却没有改变。
这里也不应把 ReAct 和 Reflexion 划成互斥功能:一次尝试内部也能总结,外层反思也能提出新的计划。文章用两个时间尺度帮助理解,不把它们当成所有 Agent 都必须遵守的命名规范。
2. 不更新权重,它到底“学会”了什么?
原论文的核心是通过语言反馈改变后续尝试的上下文,而不微调模型权重;Actor 可以采用 ReAct,也可以采用其他生成方式。论文用 Actor、Evaluator、Self-Reflection 和 Memory 描述这些责任。Reflexion 原论文,第 3 节
我会把它们翻译成四个具体问题。
| 组件 | 需要回答的问题 | 不能顺手假设的能力 |
|---|---|---|
| Actor | 根据当前任务、观察和经验,产生什么行动或答案? | 会自动执行自己写出的行动 |
| Evaluator | 本轮满足了哪些要求,哪里失败或无法确认? | 知道所有语义错误及其原因 |
| Self-Reflection | 从反馈和轨迹中,可以提出什么改进建议? | 给出的归因必然正确 |
| Memory | 哪些经验应被保留,并如何进入后续输入? | 保存过就会被正确使用 |
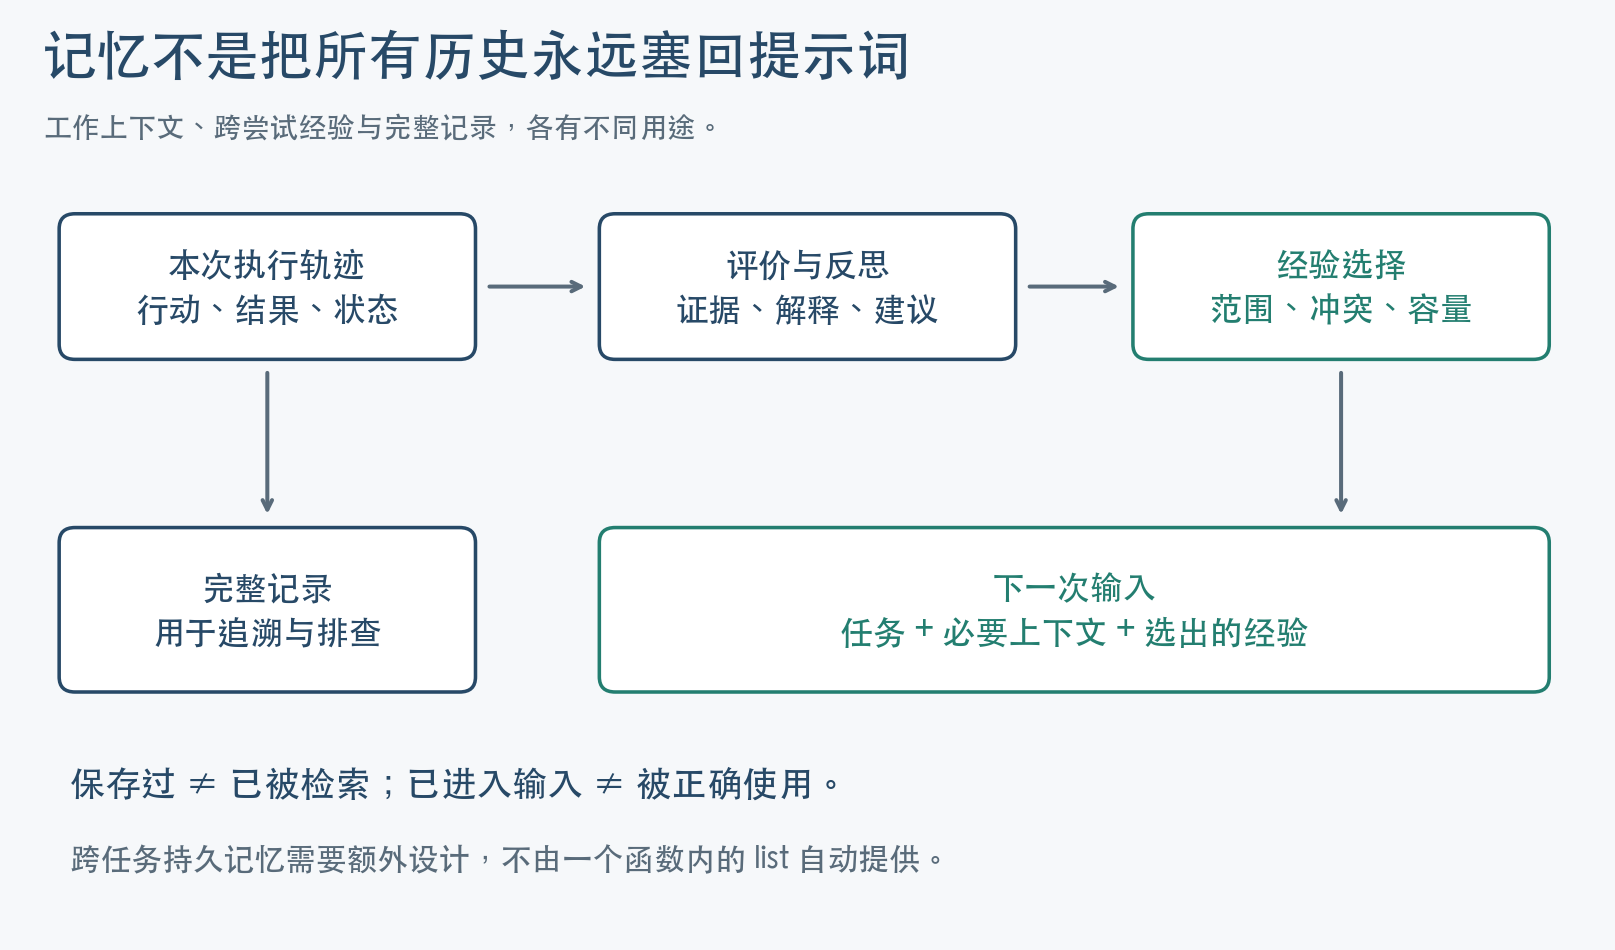
图 2:完整记录供追溯,工作上下文供当前决策,选出的经验供下一次尝试。它们可以来自同一过程,但用途和生命周期不同。
如果用符号简写,设 W 是固定模型权重,m 是经验,下一步行为由模型在任务、历史与经验条件下产生。经验变化时,输出行为可以变化,W 不需要变化。这是理解论文“verbal reinforcement learning”的方式,不能把它等同于已经进行了策略梯度训练。
这也不是免费获得能力。Actor、Evaluator 和反思都可能消耗调用、时间与 token;有的 Evaluator 是程序,不需要模型调用,有的则需要。因此成本应按实际调用累计,而不是笼统地说“每轮固定调用三次模型”。
2.1 保存 history,就算长期记忆吗?
我最初容易混淆三个层次:当前尝试的行动记录、同一任务多次尝试之间的经验,以及跨任务持久保存的知识。
代码里若在函数开头写 memory = [],经验最多活到这次函数调用结束。它可以跨越内部的几轮尝试,却不会自动进入下一个问题。
论文把跨 trial 的反思称为长期记忆,并在实际设置中限制容量,通常保留少量经验。因此,不能把“不断 append”的教学代码缺点,直接写成原方法没有任何记忆管理。Reflexion 原论文,Memory 与流程说明
真正扩展到跨任务记忆,还要处理任务适用范围、来源、版本、失效和冲突。例如“搜索词过窄时去掉一个修饰词”可以是一条有条件的经验;“永远使用宽泛搜索”就很容易误导后续任务。
3. 反思写得像回事,就代表找到了原因吗?
这是我认为全文最值得停下来的一步。
假设用户要求购买低于预算的某种商品,轨迹显示候选的颜色和尺寸合适,但价格超过预算。以下三种反思看起来都像在总结:
| 反思 | 我会如何判断 |
|---|---|
| 下次应该更仔细地寻找商品 | 没有指出证据,也没有可检查的改变 |
| 失败是因为搜索关键词不够具体 | 可能成立,但现有记录不足以支持这个归因 |
| 该候选价格超过预算;提交前逐项核对价格、颜色和尺寸 | 与可见证据相符,也提出了可执行检查 |
第三条相对有用,仍不能证明换一个候选一定成功。指出一次可观察的违规,与找出导致整个任务失败的完整原因,是两件事。

图 3:把解释直接升格为规则,可能让错误延续。检查可以过滤无证据的断言,但不能自动证明所有因果关系。
我的反思是:应该把“失败原因”先当作待检验的解释。结构上可以记录四项:
证据:候选 P 的价格是 129,用户上限是 100。
解释:本轮没有在提交前执行预算核对。
下次改变:读取价格字段,与用户上限比较后再提交。
适用范围:带明确预算约束的商品选择任务。
程序可以检查价格和上限,也可以检查有没有记录到相应步骤,却未必能证明模型内部究竟因为什么忽略了预算。如果只有一句“失败”,就更不该把猜测写成已经确认的事实。
同一个模型担任 Actor 和 Reflector,可能保留同样的盲点;换一个模型,也不等于获得独立、可靠的验收。更值得检查的是:评价是否依赖外部证据,错误是否能被暴露,结论能否被反驳。
经验内容还可能包含网页或工具返回的文字。重新交给反思模型时,这些仍是待分析数据,不应因为经过一次总结就变成系统指令。把经验放进有边界的上下文区段,有助于表达用途;真正的权限仍应由执行程序控制。
4. 为什么 WebShop 没有明显受益?
讨论中最吸引我的解释是:“它需要探索,而不只是反思。”这个方向有启发,但不能扩大成“Reflexion 天生不会产生新路径”。
原论文在 100 个 WebShop 环境上测试,在四轮后停止,报告 ReAct + Reflexion 没有明显超过 ReAct。作者将这一现象与需要更多样探索的行为联系起来。这里是特定实验的观察及解释,不是对所有电商任务、模型或搜索接口的普遍定理。Reflexion 原论文,附录 B.1
4.1 “没找到”可能包含很多不同问题
WebShop 要求 Agent 搜索、浏览商品并选择符合请求的对象。考虑一个教学案例:寻找带抽屉、特定表面颜色且不超预算的床头柜。
搜索没有返回合适结果,可能是关键词太窄,也可能是同义词不匹配、属性藏在详情页、候选没有检查完整,甚至是现有信息无法确认是否存在合适商品。
反思说“下次换一个搜索词”并没有解决这个问题。需要进一步决定:换哪个词?保留哪个候选?验证哪个属性?新的结果会如何帮助排除一种解释?
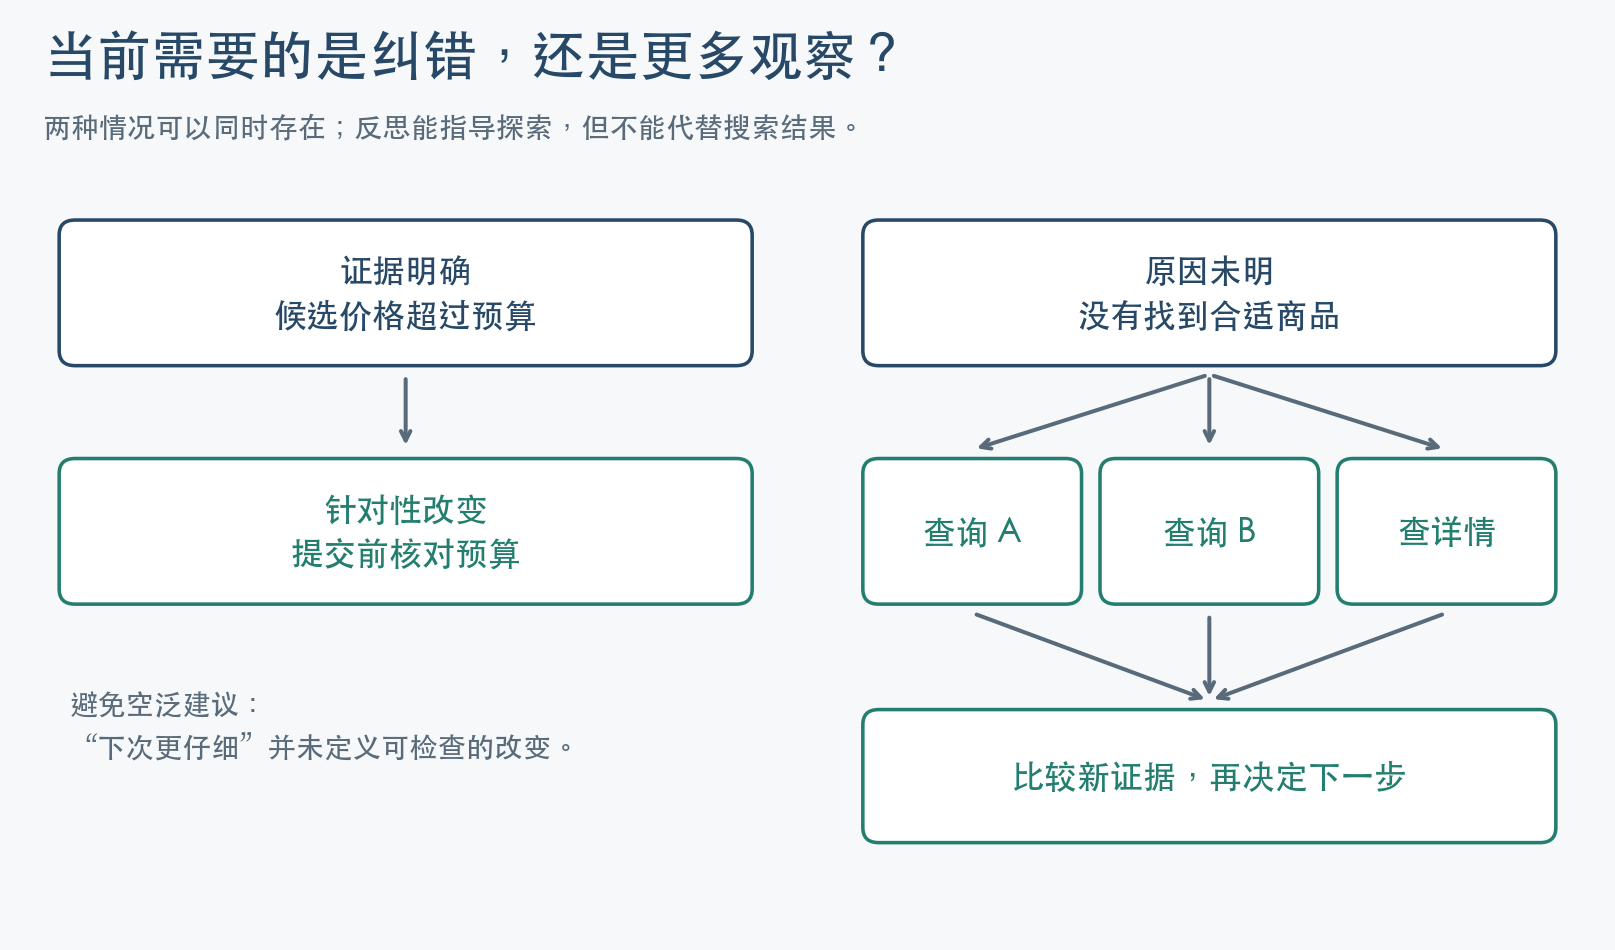
图 4:知道某个步骤错了,可以针对性修正;原因尚不明确时,需要通过新行动获取区分不同解释的证据。反思可以指导探索,但不能代替实际观察。
4.2 为什么 HotpotQA 同样涉及搜索,却可能不同?
不能简单说知识搜索总是宽容,商品搜索总是糟糕。更有用的比较是:在这个具体任务中,已知信息能否帮助构造下一步查询?
例如已经确定电影名称,只缺配乐者,缺失关系就可以指导下一次检索。商品没有命中时,则可能需要并行保留几种查询与候选,比较哪条路径能产生新证据。前者也可能遭遇实体歧义;后者也可能因为漏选颜色这样明确的错误而受益于反思。
所以我不会给两个 benchmark 贴上“能反思”和“不能反思”的永久标签。我会检查失败反馈的具体内容。
4.3 我怎样重新理解这次负结果?
“反思有帮助”的必要讨论,不是模型会不会写总结,而是总结能否转化成值得尝试的改变。若连续几轮建议都只是“更仔细”“换种方法”,我会先增加观察、保留候选或调整搜索方式,而不是继续增加反思篇幅。
同样,也不把“反馈质量 × 归因能力 × 反思质量”写成未经定义的数学定律。这些可以作为排查维度;要做乘法模型,必须先定义变量、测量方式与适用假设。
5. 从几十行代码,看清实现边界
为了保留主线,下面用 actor、evaluate 和 reflect 三个接口写一个骨架。actor 可以封装上一篇的 ReAct 循环,Evaluator 返回明确的成功状态与反馈,反思作为普通经验输入下一轮。
def reflexion(task, actor, evaluate, reflect, *, max_trials=3):
    if max_trials < 1:
        raise ValueError("max_trials must be positive")
    memory, attempts = [], []

    for trial in range(max_trials):
        # actor 必须把 memory 注入下一轮输入;本例限纯文本任务
        output = actor(task, tuple(memory))
        verdict = evaluate(output)
        attempts.append((output, verdict))
        if verdict.success:
            return "passed_checks", output, attempts
        if trial + 1 == max_trials:
            break  # 没有下一轮,就不生成无用反思
        lesson = reflect(task, output, verdict.feedback)
        memory = (memory + [lesson])[-3:]

    return "exhausted_unverified", None, attempts
它故意没有把所有生产能力隐藏在几个漂亮函数名后面:没有模型适配器、语义反思验证器、外部环境回滚,也没有工具级超时。模型是否使用经验,要由适配器和观测来确认;最多保存三条,也不代表满足总 token 预算。
5.1 score、success、停止不是一回事
score >= 1 只有在评分契约明确时才有意义。连续分数、满足部分约束和通过验收,不一定是同一概念。
passed_checks 也只表示通过当前检查集合。它不意味着所有未知输入或开放语义都已验证。运行因预算耗尽而停止,更不能标记成成功。
5.2 返回最后一次,还是最高分那一次?
反思没有逐轮改进保证,所以保留每次候选和评价记录很有用。但是“永远返回最高分候选”不是通用修复。
如果任务是纯文本生成、同一评分标准能比较候选,可以采用明确的选择策略;如果任务修改文件或外部数据,旧答案的高分不代表旧状态仍然存在。恢复旧产物需要真实的快照和验证,不能只把旧字符串返回给用户。
本例预算耗尽后返回 None 及所有尝试记录,明确没有选出已通过检查的结果。其他选择方式可以实现,但要说明依据与限制。
5.3 反思不是一种无限重试许可
参数错误可能值得修正;权限拒绝不应靠反复尝试绕过;网络超时可能表示外部操作结果未知。对于发送消息、购买或写数据库,先确认真实状态和幂等机制,再决定是否重试。
教学环境可以重置;真实系统未必可以。把“下一轮重新开始”放进流程图很容易,真正隔离工作区、恢复环境并处理中途失败,才是执行层要完成的工作。
5.4 Evaluator 一定不能用模型吗?
不能一概禁止。格式、计算、已定义约束适合程序检查;开放文本质量可能需要模型或人工判断,但要承认评价的误判和偏好。
即使使用单元测试,也要问:测试来自哪里,期望值是否正确,覆盖是否足够?模型写的测试通过编译,并不代表测试表达了正确要求。
6. 一个可以运行,但不冒充真实模型学习的演示
随文提供 reflexion_demo.py 与检查用例。解压后运行:
python3 reflexion_demo.py案例是“去掉重复项,但保留第一次出现的顺序”。第一次使用排序结果,检查发现顺序不符合要求;下一轮读取经验后改为保序去重。
这里的 Actor 和 Reflector 都是确定性的模拟函数。程序可以展示经验传递、明确终止、预算耗尽与错误建议的后果,却不能证明真实语言模型会准确归因。示例甚至刻意让一条错误建议导致下一次更差,以提醒自己不要假设反思必然有效。
演示检查以下路径:第一轮直接通过;失败后使用经验通过;错误经验导致退化并耗尽预算;最后一次失败后不再调用反思;拒绝零次尝试。完整代码同时保留每次输出、反馈和经验,方便逐项查看。
7. 实验成绩不能只看最好的一行
论文的 HumanEval Python 结果是 91.0%,对照表中的 GPT-4 为 80.1%;MBPP Python 则是 77.1%,低于表中 80.1%。编程循环使用自生成测试,这些结果不应被解释为“一次模型调用就有这个通过率”。Reflexion 原论文,第 4.3 节及表 1
我更想把这组正反结果放在一起读:同样是编程任务,反馈环节的差异可能影响最终表现。要理解一个数字,需要同时看到模型、任务集合、尝试预算、测试来源及最终评测协议,而不是只记住“提升了多少”。
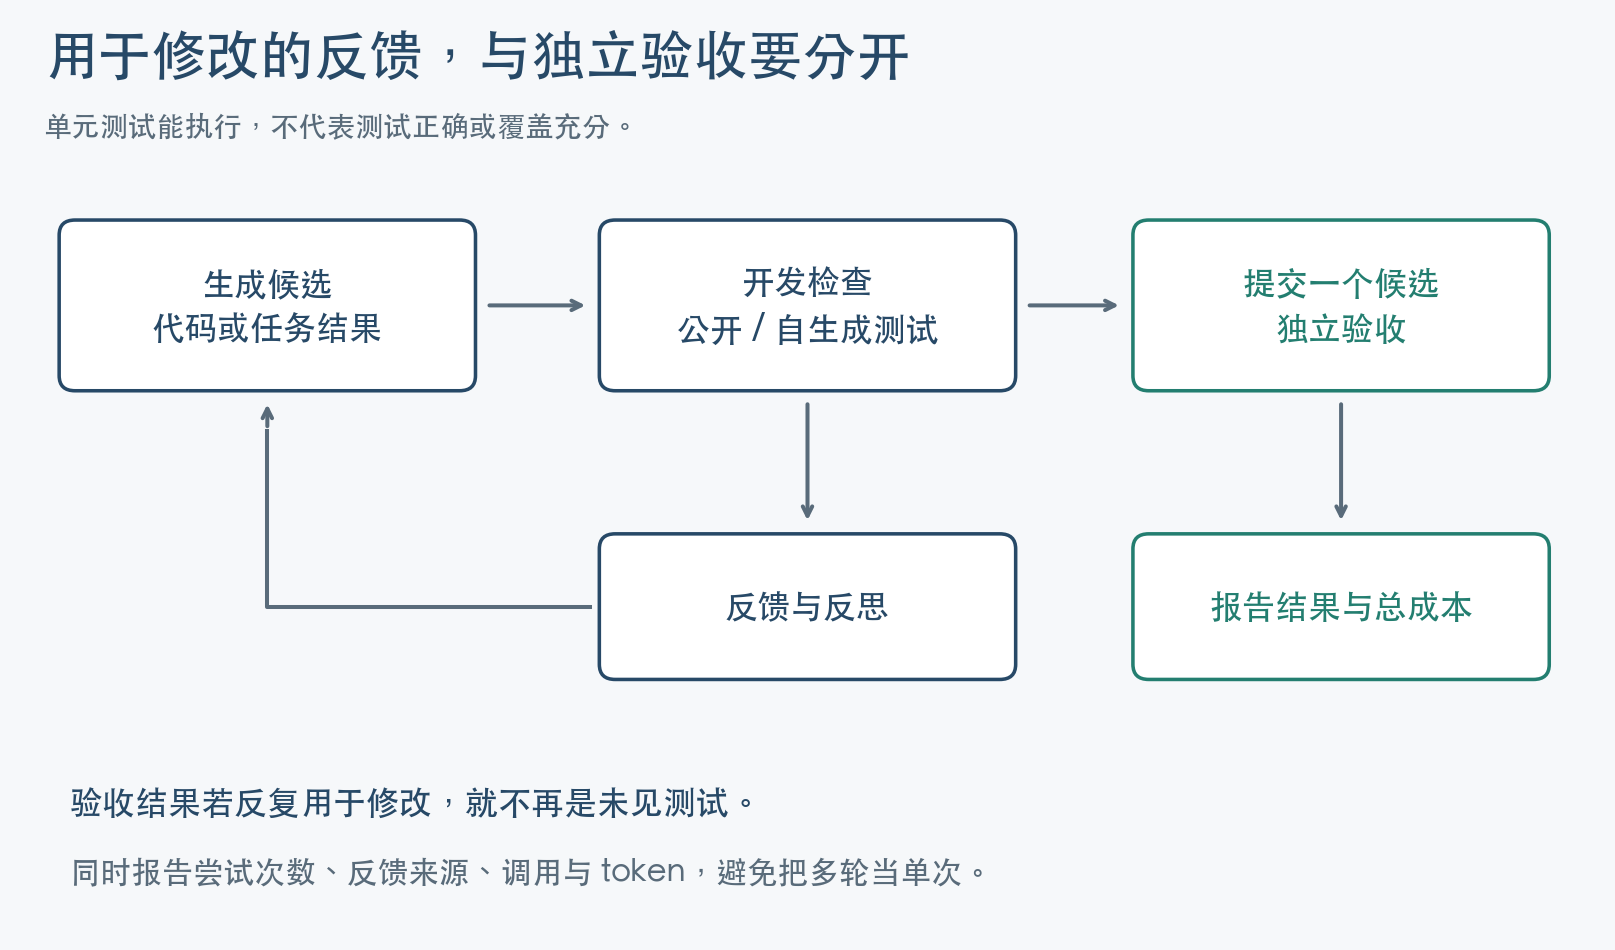
图 5:开发反馈用于迭代,独立验收用于检查提交结果。若把验收答案反复用于修改,就不能继续把它称为未见测试。
为博客做一个演示时,我可以设计公开检查,帮助读者理解流程。但如果之后要比较真实模型,必须另外保留评测任务,并明确这些任务有没有在提示词调试、经验生成或选择模型时被看过。
“通过了自己写的测试”与“通过独立检查”应分别记录。即使最终测试独立,也需要报告多轮生成的总成本,否则读者容易把多轮结果与单次调用结果直接比较。
8. 我的反思:什么时候值得加入 Reflexion?
我现在不会先问“这个 Agent 有没有反思模块”。我会沿着一次失败问四个更具体的问题。
第一,失败反馈提供了什么新信息? 如果只有未完成状态,先检查轨迹里是否还有足以定位问题的证据。不能要求反思模型凭空补出环境没有提供的信息。
第二,建议能否变成可检查的改变? “下次优化策略”没有办法验收;“提交前读取价格并与预算比较”至少定义了一个检查点。
第三,是否值得再尝试? 可恢复、可验证且成本适中的任务更容易建立有效循环。若下一轮只是重复调用同一个失败工具,应先改变信息获取或执行策略。
第四,怎样知道改变来自反思? 多一次尝试本来就可能成功。看到“第一次失败,第二次成功”,只能证明这条记录发生了什么,不能单独证明反思提供了增益。
我会把下面这张表作为后续真实实验计划,而不是本文已经完成的实验。
| 对照 | 下一轮能看见什么 | 希望区分的因素 |
|---|---|---|
| 直接重试 | 相同任务,不保留上次经历 | 单纯增加尝试机会 |
| 保留原轨迹与反馈 | 上次输出、行动和检查结果 | 额外信息带来的影响 |
| 保留反思与反馈 | 压缩后的改进建议和检查结果 | 经验总结的影响 |
三组固定模型、任务集合与最大尝试次数,另设相同总预算上限,记录实际调用和 token;报告成功率、成功所需尝试数、失败类型与成本。若反思组上下文更短,还要把信息压缩的作用与“反思措辞”的作用分开,不将所有差异都归因于一种机制。
我尤其想看两类失败:一类是证据明确但未被下一轮使用;另一类是根本没有足够证据,却产生了自信的解释。前者更像执行与上下文问题,后者可能首先需要新的观察。
这也是我从 ReAct 走到 Reflexion 后最大的变化:评价一个系统,应该追问经验是否有依据、是否影响行为,以及影响之后有没有验证。反思可以帮助组织经验,但“我吸取了教训”本身不是证据。
9. 面试时,我希望能讲清楚的六个问题
ReAct 与 Reflexion 是什么关系? 可以把 ReAct 放在一次尝试的 Actor 中,再在外层加入评价、经验与下一次尝试。它们可以组合,不是互相替代的两个接口。
不更新权重,为什么行为会改变? 后续输入加入经验,改变了生成条件。应区分上下文中的适应与参数训练,不把论文用语直接等同于策略梯度更新。
Evaluator 怎么设计? 先定义可检查要求、反馈来源和成功标准。程序、模型与人工评价各有覆盖范围,评价器自己的错误也要被记录和分析。
错误经验怎么办? 保留证据与适用范围,避免提升为高权限指令;对可验证部分做检查,对冲突或不确定归因保留状态。没有一个万能验证器能确认所有经验。
什么时候停止? 通过当前验收、预算耗尽、不可恢复错误或需要外部决策,都可能停止。停止原因需要明确,不能用同一个 ok 表示。
怎么证明反思有效? 与同预算重试及保留原轨迹的方案比较,检查成功、成本和退化。先验证代码的控制流程,再评测真实模型,不能把两种证据混在一起。
与 Self-Refine 比较时,我会再补一句:它侧重输出、反馈与修改的迭代;不要用“有没有一个 critique 字段”判断方法归属,仍要看反馈来源、记忆和下一轮生成怎样组织。Self-Refine 原论文
参考资料与阅读延伸
- Shinn et al. Reflexion: Language Agents with Verbal Reinforcement Learning,NeurIPS 2023;本文核对版本为 arXiv v4。方法见第 3 节,编程实验见第 4.3 节,WebShop 见附录 B.1。
- Reflexion 官方代码。复现实验时应固定代码版本、模型与评测设置。
- Madaan et al. Self-Refine: Iterative Refinement with Self-Feedback。
- 本站:ReAct 博客 · 上下文、记忆与多 Agent · 评测、观测与项目答辩。
本文由我的学习讨论整理,结合论文核查并补充工程辨析。图中流程是教学说明,代码使用模拟组件;后续对照实验是计划,尚未开展真实模型性能复现。
